World Model, Video Generation 和 Representation

LLM 当前的研究基本已经完成并且处于大规模应用和商业化的阶段,Spatial Intelligence 是当前 AI 界还未解决,并且是需要很长一段路才能解决的问题。
World Model, Video Generation 和 Representation
序
Spatial Intelligence 相关的研究,大多可以落到三点:
- World Model: 通过视频数据来学习视频帧之内和之间的动作,比如 OpenAI 早期的 VPT,Google DeepMind 的 Genie 系列;
- Video Generation: 通过视频生成来合成实际没有发生的世界状态,比如碰一下杯子后,杯子的运动学状态等,典型研究如 Sora;
- Representation: 如何找一个好的表征来压缩/建模视频和图像,使得其中的视觉信息、运动信息等内容不丢,如 Lecun 的 JEPA 系列;
关于数据层面上,早期研究大幅度利用了游戏数据,因为游戏视频有几个特点:
- 干净且统一(地图、任务、色彩),不会出现很多 OOD 的变化
- 数据容易采集,相比 Robot 公司需要很多人戴着头显做操作
- 采集效率高,基本都可以在线上完成
- 脏数据/噪音较少(相比互联网数据来说)
但是后期随着应用场景的泛化,比如 Robotics,逐步过渡到利用大量的互联网视频数据来建模,各类的研究已经持续了 2 年左右,但是很多领域都没达成共识,比如
- 世界理解上没有出现明显的 Scaling Law:这里指的是场景的 Zero-shot,比如从游戏 A 训练的模型,是否能够在游戏 B 上也做到差不多的水平?这里讲的更多的是“组合泛化”的概念,而不是单纯的把轨迹训进模型里;
- 视频生成,是否内部真的包含了足够的物理信息?我们所看到的 MiniMax H3、Seedance,都存在大量物理不真实的情况(即使是常见视频和 prompt);
- 如何表征多模态数据? 只看像素的建模是不够的,因为大部分表征即使能够正确编解码 video,但是没有办法让 Robot 读到真实世界的信息;
下面是近两年来关于这个主题的研究
World Model
VPT
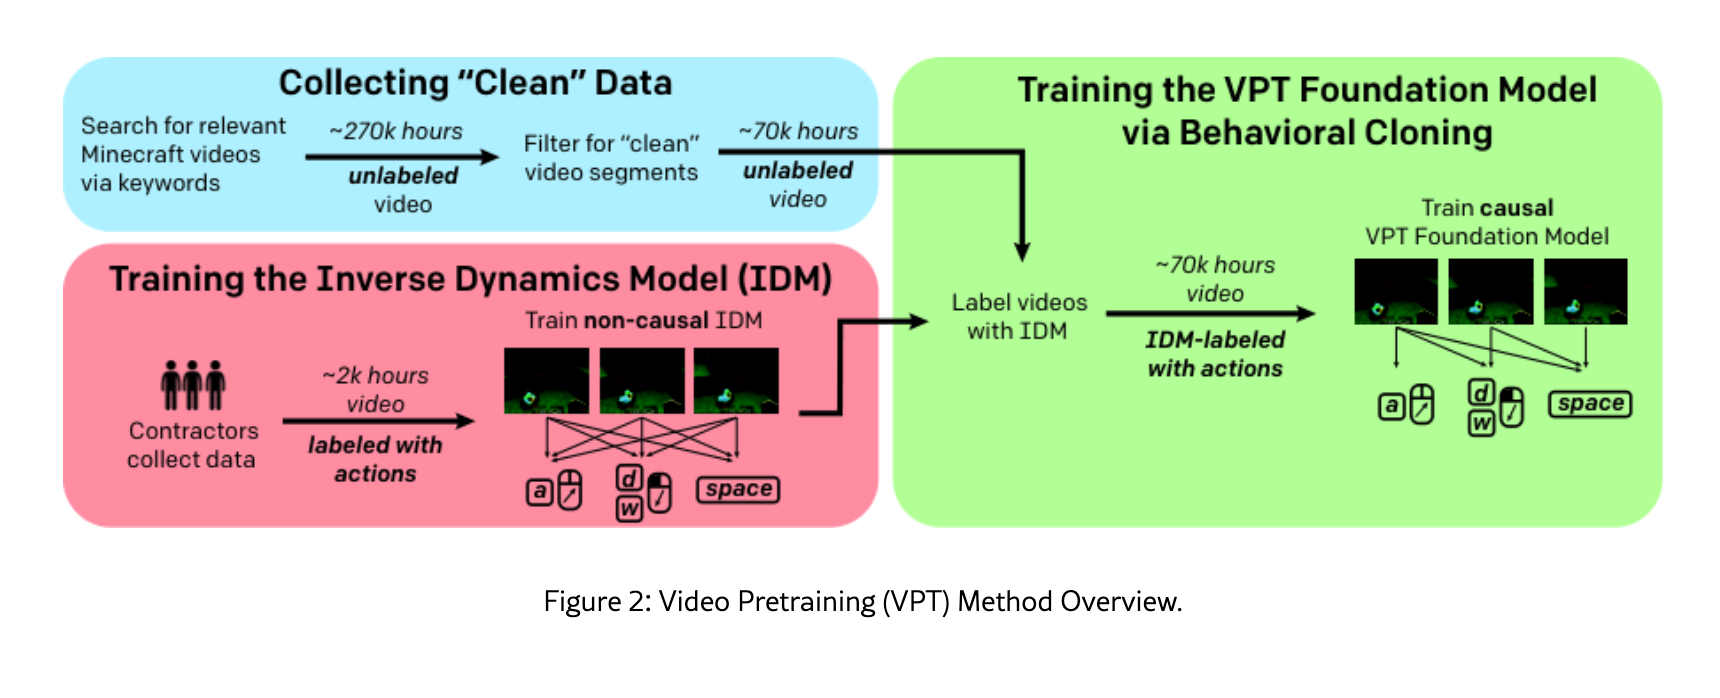
Video PreTraining (VPT): Learning to Act by Watching Unlabeled Online Videos, 2022 年 OpenAI 发布的(OpenAI 对 Video 多模态的研究非常早,甚至是 robotics 上也早于很多人的想象)
- 背景:互联网有大量游戏和操作视频,但通常没有键鼠或机器人动作标签,无法直接用于 BC(Behaviour Cloning);从零强化学习又很难探索出长链条技能;
- 解决思路:用少量带动作标签的数据训练逆动力学模型(IDM),给大量无标签视频补上动作标签,再训练策略。
- 标签来源?1) 研究者雇人玩 Minecraft,同时录制游戏 video 和键盘 action,按时间对齐,来自于操作日志; 2) 用 1 的数据训模型,再利用互联网视频,算出相邻 window 之间的 action,作为伪标签(这里应该会产生误差)
- 动作表征?直接在 transformer 上加 action head 生成离散值;
- 模型结构:分两个,一个是 IDM 补标签 model,一个是生成 action 的 model,前者能看到未来,后者是 casual attention;
- 具体方案:先用约 2,000 小时带键鼠记录的 Minecraft 数据训练 IDM,通过动作前后的画面推断动作;随后为约 70,000 小时网络视频生成伪标签,训练仅依赖历史观测的行为克隆策略;最后进行任务数据微调或强化学习微调。
- 效果:预训练模型已能砍树、制作木板和工作台。加入强化学习微调后,在 10 分钟游戏回合中制作钻石镐的成功率为 2.5%。这个钻石镐结果包含在线强化学习,不能归为纯离线视频学习。
Genie
Genie: Generative Interactive Environments
- 背景:传统世界模型依赖“观测—动作”配对数据,普通视频缺少动作记录;视频生成模型也通常不支持逐步控制。
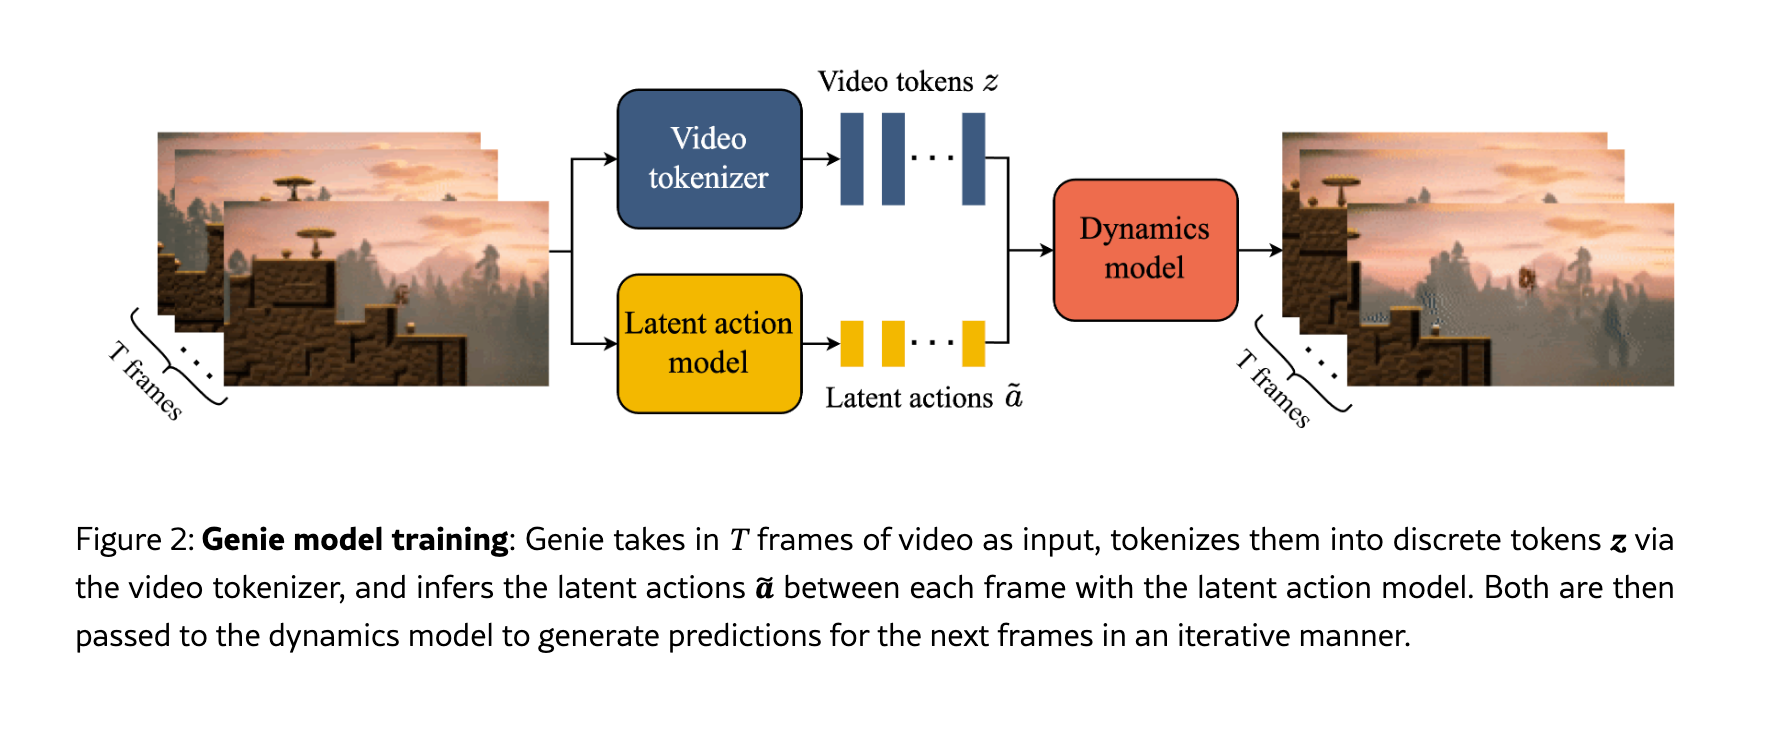
- 方案:和 VPT 类似,从帧间发现 latent action,再学习这些动作生成的画面;
- Tokenizer: 视频 ST-Transformer 编解码的 VQ-VAE 有 1024 个码,动作有 8 个码;
- LAM(Latent Action Model): 编码器看到前后两帧图片,训出来的 latent action,并压到 8 个码本之中;
- Dyanmics Model:接收 action code 和上一帧,预测下一帧;
- 效果:能把 2D 图片变成 2D 可交互环境
观点:这个架构相比于现在的 e2e model 的训练方式似乎是有点落后了,本身在 action 压缩到 码本大小为 8 的空间里,其实是有信息损失的。
LAPA
Latent Action Pretraining From Videos
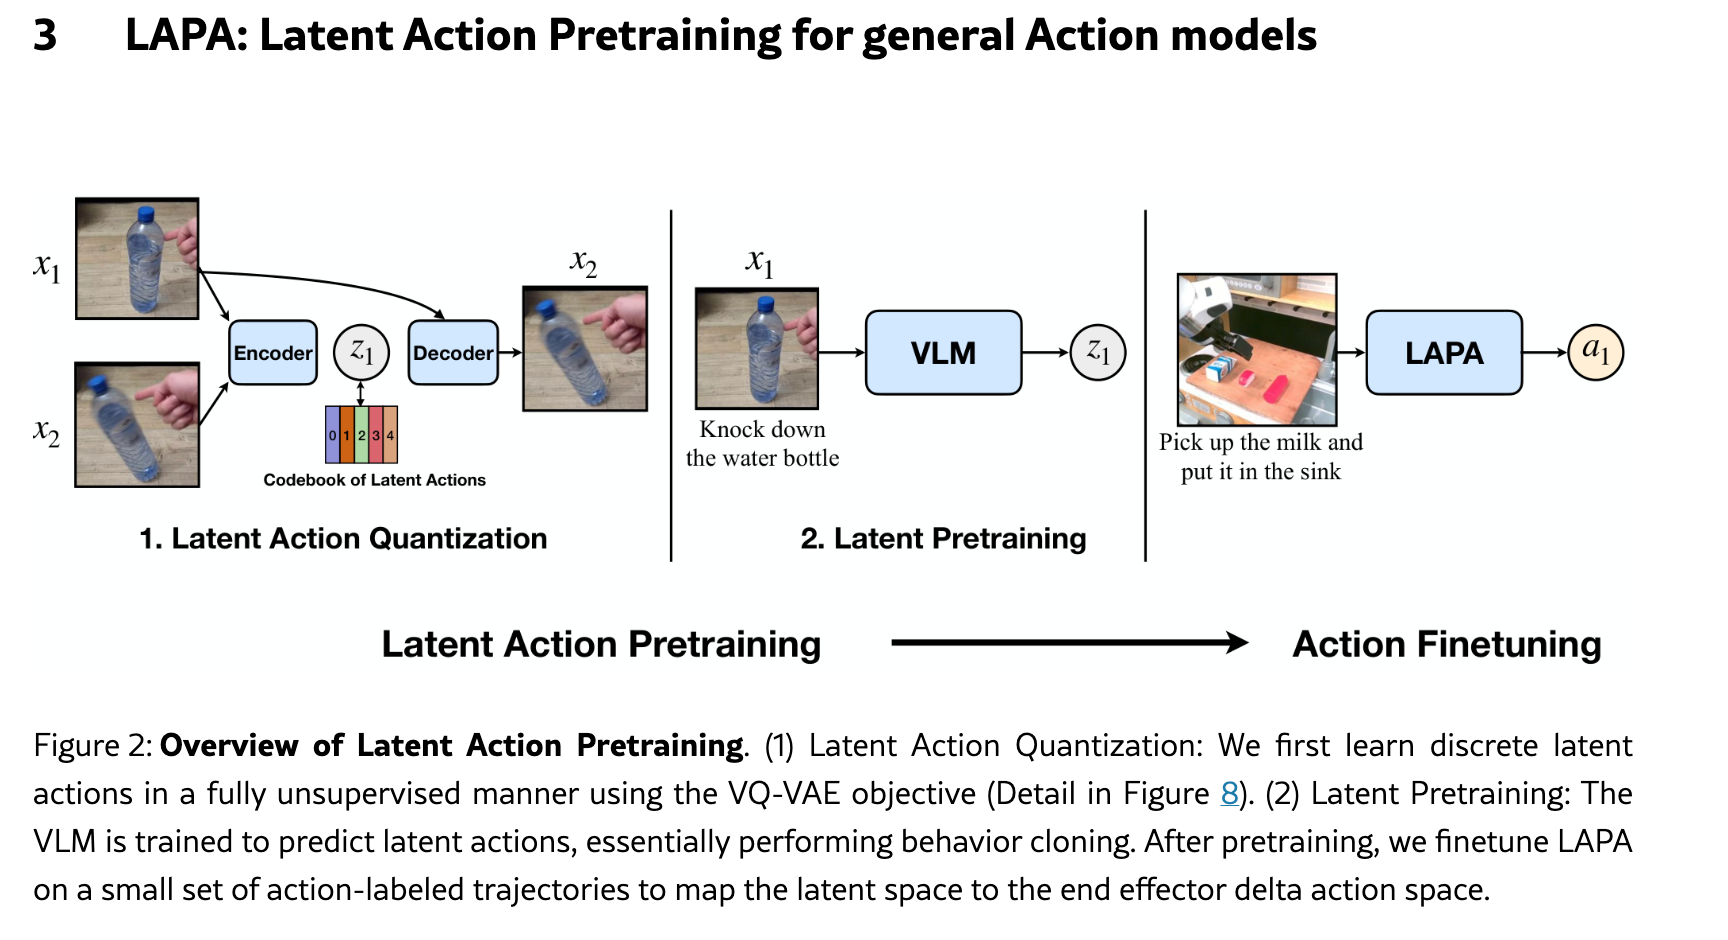
- 背景:24 年发布的,VLA 模型依赖昂贵的机器人遥操作数据,而且不同机器人的动作空间不统一,人类视频难以直接复用。本质上实际在训一个 VQ-VAE 的视频 Encoder/Decoder;
- 方案:用的是 unsupervised 的训练方法(现有很多 WAM 也是类似的思路)
- 输入相邻视频帧,使用 VQ-VAE 转成离散 action 信号(固定大小的 codebook),训出 action 的 codebook(VQ-VAE),再用 action code 和视频帧过一次 Decoder 生成视频帧
- VQ-VAE: Vector Quantization,连续向量转离散信号的编码器
- 这里的 Encoder 和 Decoder 并不是可重建的
- 用训练好的 VQ-VAE codebook 和视频帧做大量的 pretraining,得到 image+text -> action 的训练数据
- 少部分 teleop 数据 fine-tune
- 输入相邻视频帧,使用 VQ-VAE 转成离散 action 信号(固定大小的 codebook),训出 action 的 codebook(VQ-VAE),再用 action code 和视频帧过一次 Decoder 生成视频帧
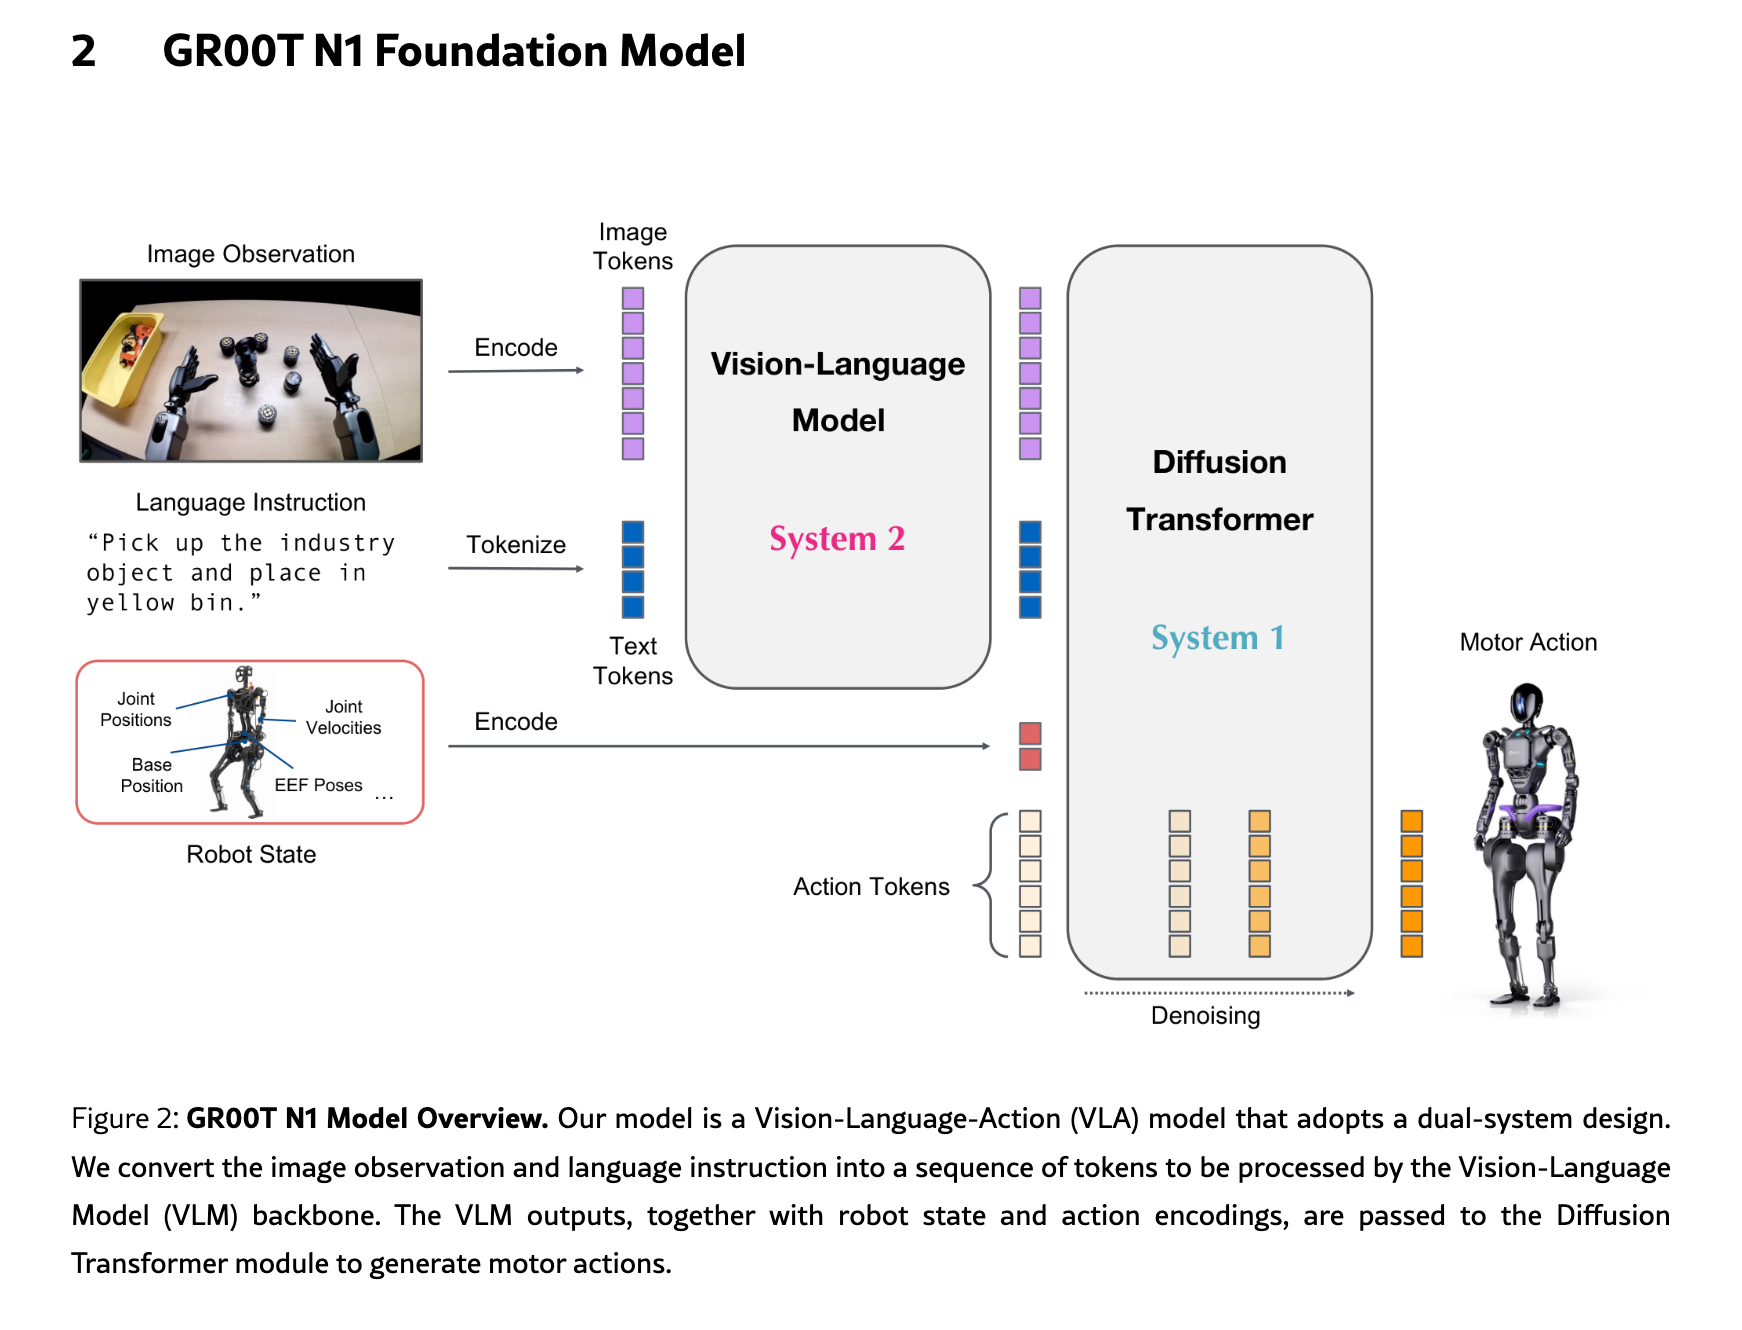
GR00T N1
GR00T N1: An Open Foundation Model for Generalist Humanoid Robots
- 背景:NVIDIA 25 年发布的,让人形机器人理解 Vision + Language,生成连续 action,并且适应不同机器人本体形态。
- 解决思路:采用理解与控制相结合的双系统架构,并混合真实机器人、人类视频和合成数据训练。
- 具体方案:System 2 使用 Eagle-2 VLM 编码图像和指令;System 1 使用 DiT,通过 flow matching 生成连续动作块。不同机器人采用专属状态与动作适配层。人类视频通过 LAPA 式潜在动作参与训练,合成数据来自视频生成和仿真轨迹扩增。
- 这里也首次正式提出了 Data Pyramid 的概念
Isaac 0.5
Introducing Isaac 0.5: An Open-Source Embodied Foundation Model:
- Perception 发的模型,36B + MoE,动态激活参数,特点是支持「视频理解」+「动作生成」
- 训练
- 目标:视频理解、空间定位、任务进度预测、动作生成
- 预测画面里和任务相关的状态变化(percepts)
Video Generation
Sora
Video generation models as world simulators
- OpenAI 在 2024 年发布的 Sora 还是值得讲一下,“高开低走”,再过几年,可能很多人已经都不记得这个模型了
- 背景:长视频存在大量的身份、运动、空间不一致的问题,第一个长视频的生成模型
- 方案:图像和 Image token 化(这里的 tokenizer 怎么设计的没有写),然后用大规模的 transformer-diffusion 架构实现 denoise 过程,训练中保留了不同尺寸视频,并使用了大量的文本描述,增强 instruct-following 能力;
- 核心是把当时图像的 DiT 架构迁移到了视频上, 并且加入了“时空一致”的能力,具体细节没有说
Genie 2
Genie 2: A large-scale foundation world model, DeepMind 2024 年发的世界模型,已经和 26 年 WorldLabs 发布的 Marble 有些类似了
- 背景:Agent 需要大量的环境来做真实交互,所以 Genie2 期望做的事情是 Image-to-Environment,从 2D 图片变成一个三维可交互的环境
- 方案:和上面的方案类似,用 casual-transformer 训练,每一步输入历史帧和 action,生成下一帧;
- 记忆怎么做的? report 里没有细写,考虑到 context 不长,有可能本身就是模型 pretraining 数据带来的能力;
- 效果:展示了移动、开门、跳跃、物体交互以及离开视野后的场景记忆;一致环境最长可维持约 1 分钟,多数示例为 10–20 秒
Dreamer 4
Training Agents Inside of Scalable World Models
- 背景:在游戏里训练 Agent,需要一个世界模型(能看懂 image+action -> 下一帧),这样预测的下一帧可以作为 Agent RL 的 reward,(其实跟机器人会非常像?)
- 方案:
- Tokenizer: Tokenizer 训练用的是 image 重建和损失感知(随机遮挡 patch 做预测),采用 casual transformer 做编码器(并且这一帧的编码会利用上一帧的信息)
- 网络结构采用 Dynamics Transformer,接收历史视觉表示,动作,噪声等,然后 block-casual attention,帧内交叉,时间方向不能看未来
- Shortcut Forcing: denoise 的步长也同样可以做预测,并且这里
- 特点
- 能预测更多的交互动作,比如 MineCraft 里砍树等,原因是粒度更细的 token,更长的上下文,
Representation
RAE / VAE / V-RAE
- VAE(Auto-Encoding Variational Bayes): 非常老的概念了,本质上学习的是数据对应的“采样分布”;
输入图片 x ↓ 编码器输出分布参数 μ(x)、σ(x) ↓ 从这个分布采样潜变量 z ↓ 解码器重建图片 x̂- RAE(Diffusion Transformers with Representation Autoencoders): 用预训练视觉表征构建图像潜空间,有了大模型以后,直接用预训练过的模型视觉表征,再单独训一个 decoder,组成了一个统一表征;
- V-RAE(V-RAE: Rethinking Video Latent Spaces for Generation): 还是 RAE 的思路,放到 video 上,加入时间维度以及保证运动连续性等重建指标
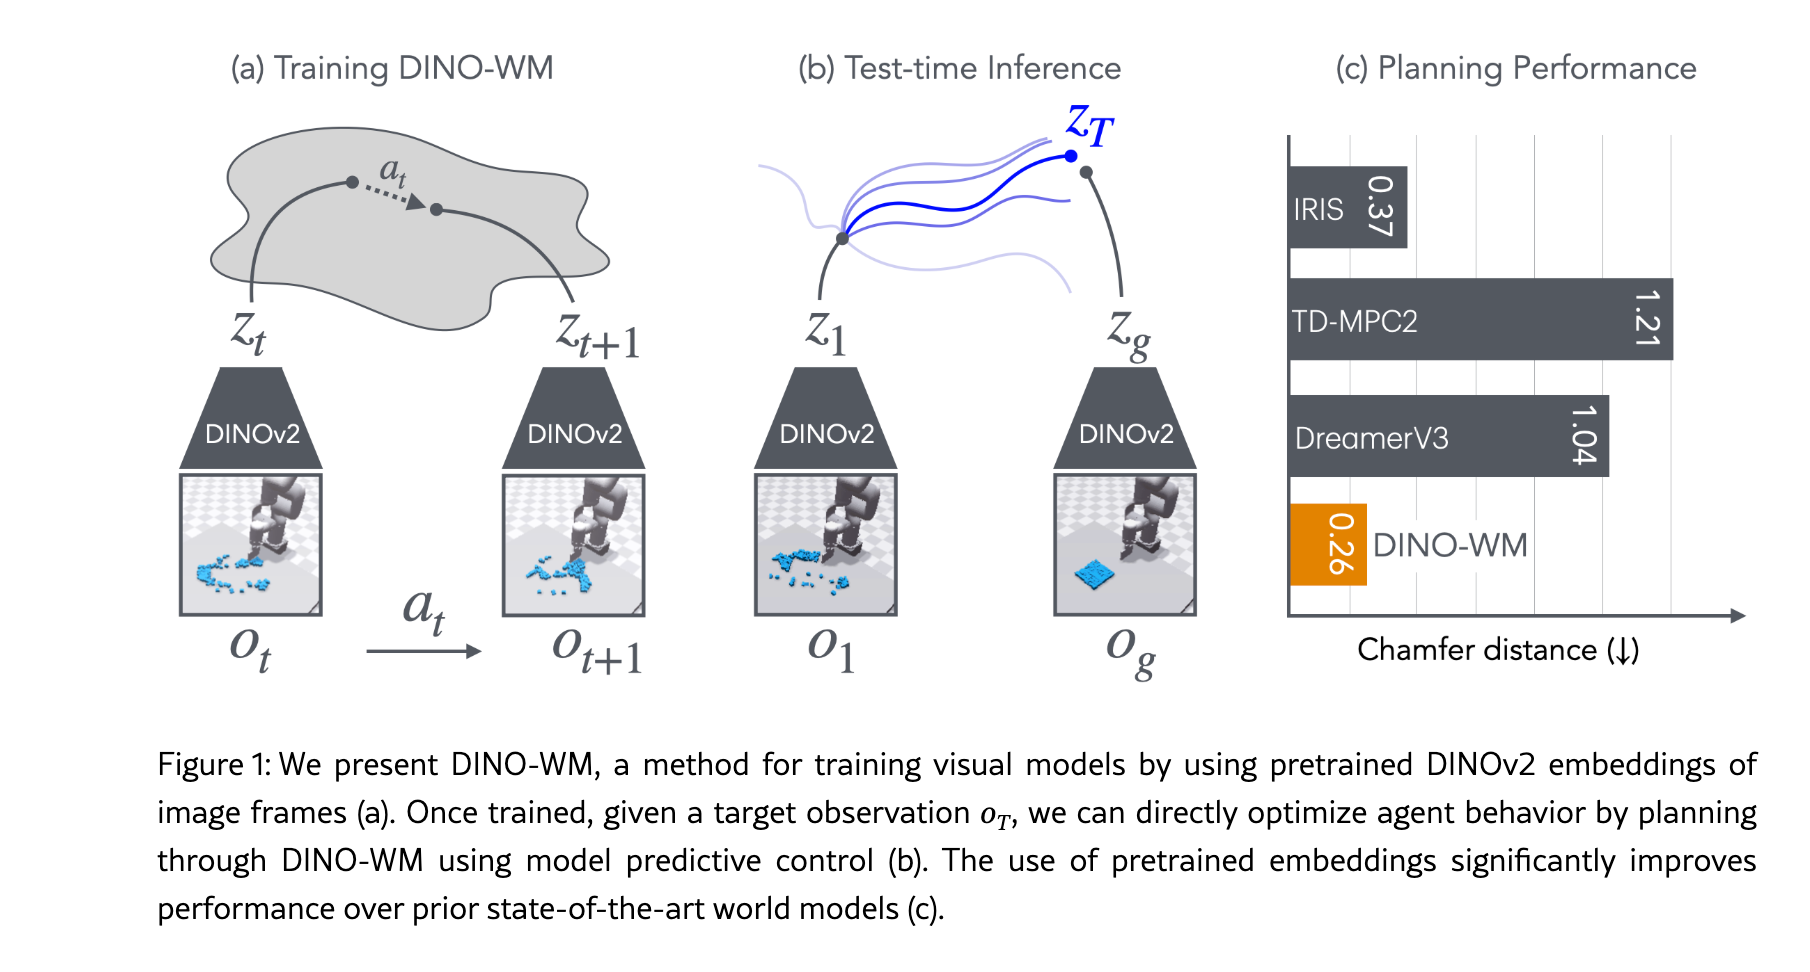
DINO-WM
DINO-WM: World Models on Pre-trained Visual Features enable Zero-shot Planning
- 背景:像素重建容易消耗大量能力拟合纹理细节;任务专属奖励和策略训练又限制世界模型的复用;
- 方案:其实和 Genie2 这些会很类似,只不过是用了 DINOv2 来做图像的编码,都是把相邻帧之间的 latent/hidden states 作为动力学模型的表征,学两个东西:
- o(t) + z -> o(t+1): 当前状态加上一个动作,预测下一个状态
- o(t) + o(t+1) -> z:状态变化预测动作
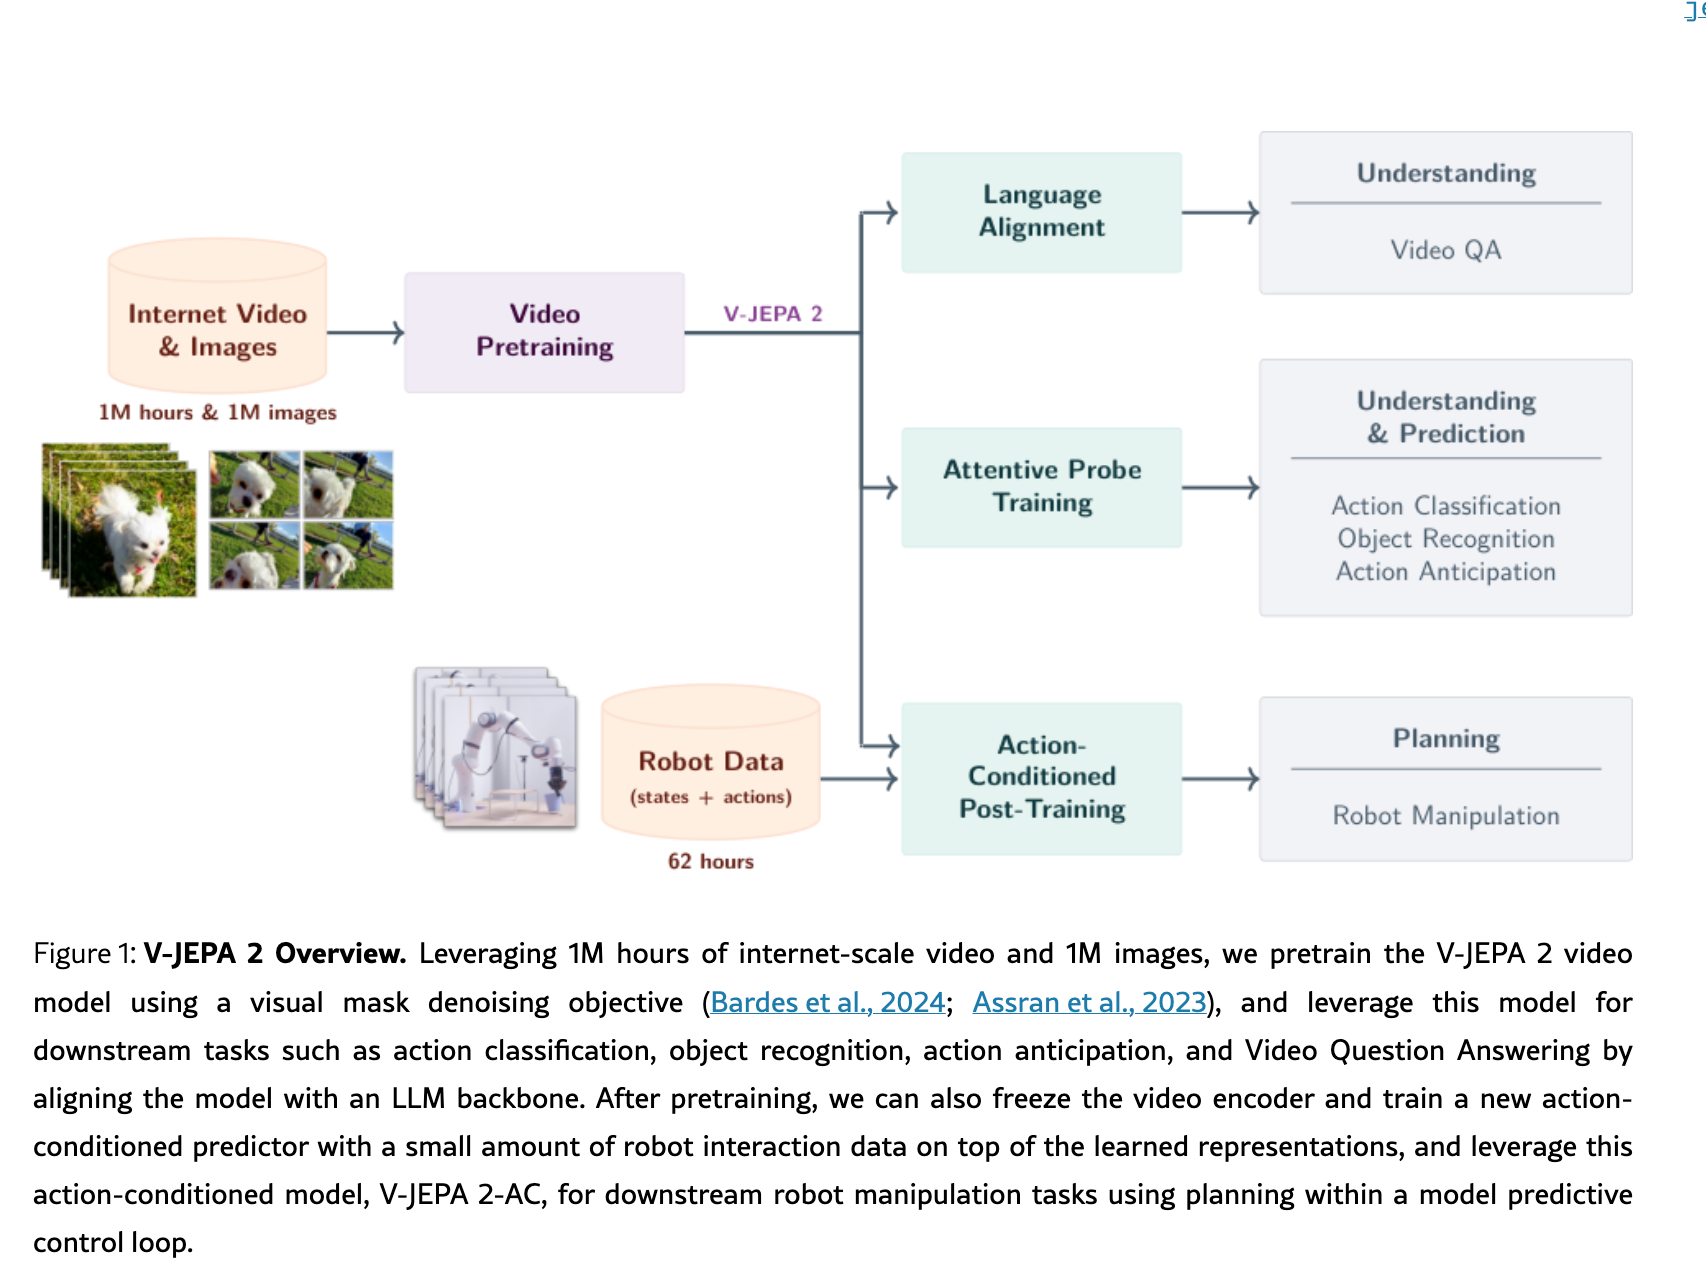
V-JEPA 2 / V-JEPA 2.1
V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning
- 背景:逐像素预测需要处理大量与任务无关、不可预测的细节;模型需要从观察中学到可用于理解与控制的表示。
- 解决思路:在表示空间预测被遮挡的视频内容,再通过少量机器人交互数据补上动作条件。
- 具体方案:在超过 100 万小时互联网视频及图像上进行 JEPA 预训练:上下文编码器和预测器预测目标编码器的特征。随后冻结视觉表示,训练 V-JEPA 2-AC,根据历史特征和动作预测未来特征,配合目标图像进行 MPC。
JiT
Back to Basics: Let Denoising Generative Models Denoise by Kaiming He
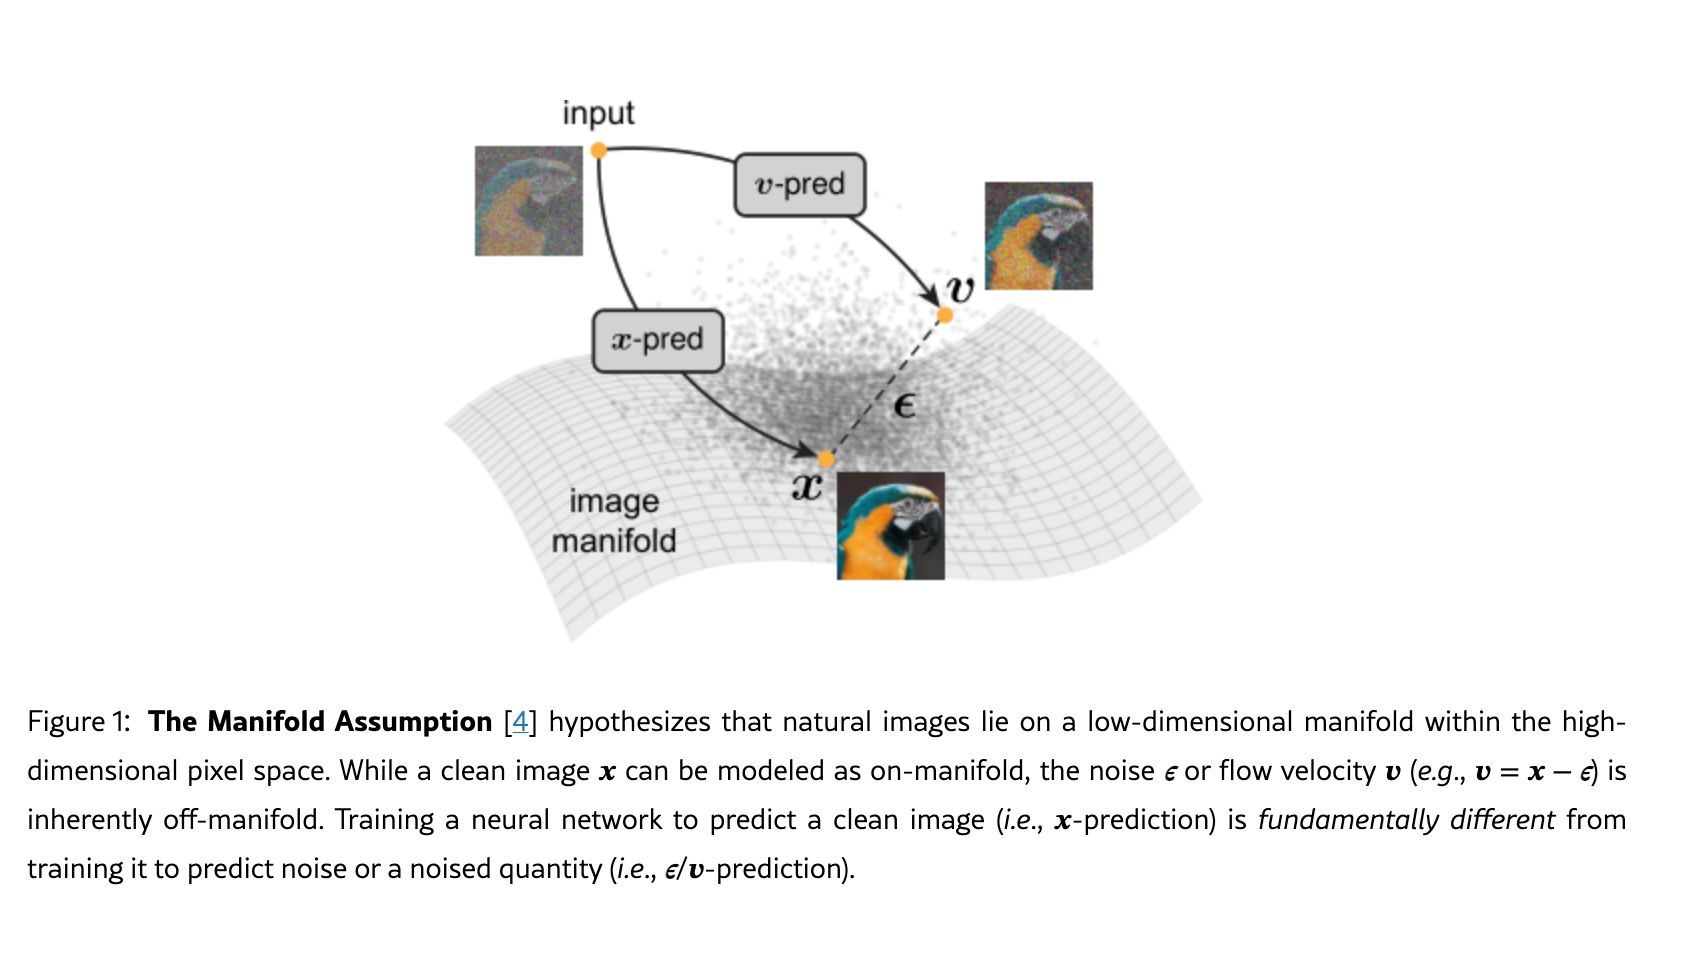
- 背景:当前 denoise 的过程中,都是通过预测 noise 来得到最后的 image,但实际上噪声是个高维且难以预测的目标,如果直接预测目标,可能就能转化成一个低维目标预测,模型的结构和效率会更加简单和准确。
- 方案:
- Manifold Assumption: 一张 256x256 的图片有 20w pixels,可以看做是 20w 维的高维数据,但实际上表达内容(比如一只猫的轮廓),可能只占很小的一部分
- 相比传统的 DiT 网络结构有两个改动:1) input 变成了 patch 后的像素,不做任何的压缩 2) output 换成了目标而不是 noise