聊聊最近很热的 RSI

关于 RSI 的资料非常多, 收集了部分从 2022 年至今相关主题的标志性文章,做了一次深入的调研。
随着 Long-Horizon 任务和 AI for Science 的流行,RSI 越来越容易从网上的讨论里听到,但研究下来发现 RSI 当前进展并没有我们想象的那么快,以及做好一个完美的 RSI 实际上是非常难(哪怕是只在一个领域内)。
序
说到 RSI,大家的理解和做法都不一样,有利用 Harness 来实现的多 Agent 流水线 Loop 的,也有结合 Model Training 实现让模型自我提升。综合下来,RSI 的路线可以分为以下几类:
- L0: Training Data 自动更新:利用某些机制让每一轮新的 Training Data 驱动模型迭代;
- L1: 依赖外部 DB 充当记忆和反馈:通过 Harness 工程让每一轮模型的 Context 越来越丰富,从而 Rollout 出更好的结果;
- L2: Agent 自我改进:确定 verifier,每一轮直接修改工程框架,逐步适配出适合某个领域的 Agent;
- L3: Exploration 自我迭代:Long-Horizon 任务里,探索是一个很重要且成本很高的事情,让模型每一轮的探索更加轻量;
- L4: 自己出题自己解:适用于数学或科学领域,“白手起家”,自己构造问题和环境(或者根据问题改变环境),拿到最后适合训练的样本再去训模型;
L0: 自动更新训练数据
STaR: Self-Taught Reasoner — Bootstrapping Reasoning With Reasoning
- 2022 Standford 发布的,https://arxiv.org/html/2203.14465v2
- 背景:当时很多 QA 问题只有问题和标准答案,缺乏推理过程,STaR 期望让模型在推理过程中自动更新训练数据(加上推理过程),然后形成一个 fine tune 的 loop。
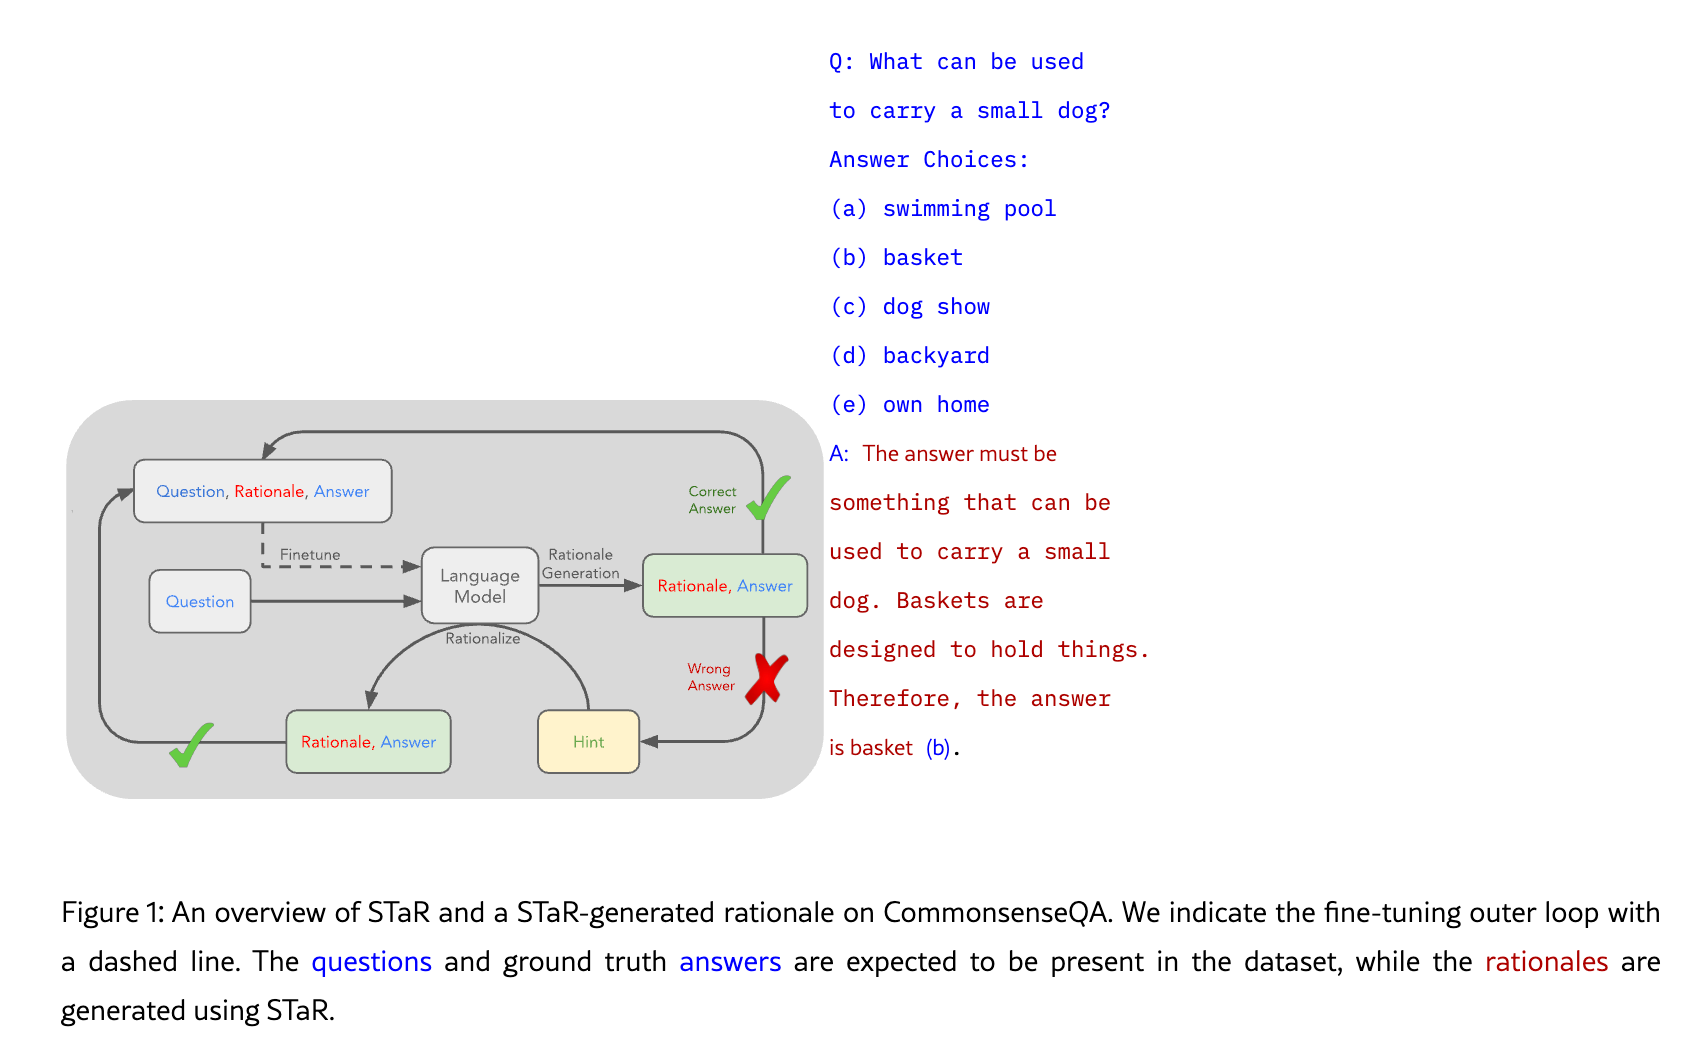
流程如下:
- 模型基于 Question/Answer 推理,得到正确答案后,把训练数据更新成推理数据;得到错误答案,进行推理过程修复;最终得到 Question-Rational-Answer 的样本;
- Loop 开始,基于 1 的数据 Fine-Tune,微调后的模型再对 Question-Rational-Answer 推理,正确数据保留 Rational,错误数据继续优化 Rational(优化方式是给同一个模型 Answer 后,反推推理过程);
- 重复 2;
| 方法 | 准确率 |
|---|---|
| Few-shot Chain-of-Thought | 36.6% |
| 直接学习标准答案的监督微调 | 60.0% |
| STaR,不使用 rationalization | 68.8% |
| STaR,使用 rationalization | 72.5% |
观点:整体思路是通过修复 Training Data(强化推理过程) 的方式来不断提高模型能力,但本身提供“推理过程”才是智能的关键,这里通过“先给答案”的方式尝试激发出模型的能力,是一种思路。
Self-Rewarding Language Models
- 24 年 Meta 发布的,Self-Rewarding Language Models
- 背景:当时,后训练里强依赖 RLHF 人工 feedback 来训 reward model,但是 reward model 停滞一段时间后,很容易被击穿,Meta 期望使用 LLMM-as-a-judge 的方式来不断形成 DPO pair 数据来驱动 RL loop;
- 方案:有两个 model(同一套权重),每一轮
- model 推理,产生一批候选 Response
- LLM-as-a-judge,对候选打分,形成 DPO pair 对
- DPO RL,回到 1
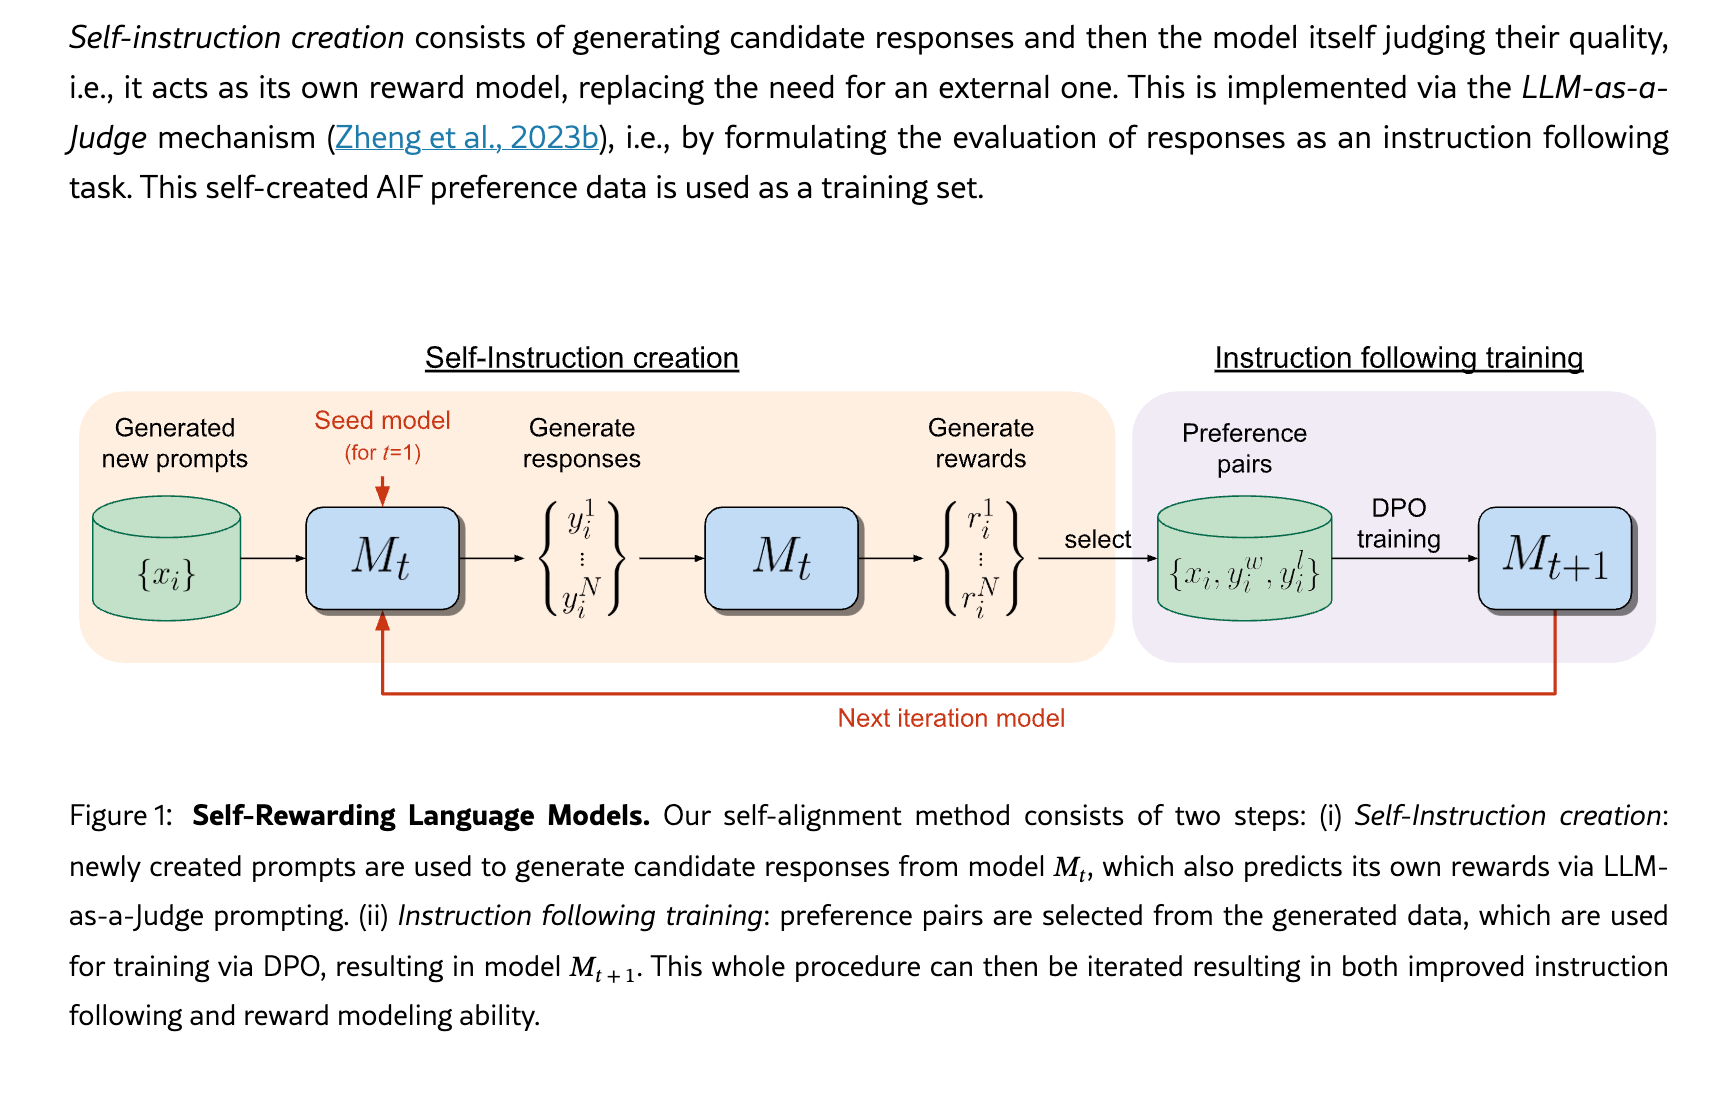
观点:这里还是自我迭代产生 DPO training data 的过程,但是有一个很大的 bug 是,”自己生成 → 自己评判 → 用自己的偏好训练自己“ 不一定能够站得住脚。
L1:利用记忆和反馈发现更好的解法
Self-Refine: Iterative Refinement with Self-Feedback
- 23 年提出的,https://arxiv.org/html/2303.17651v2,会比较类似现在的 harness,不经过模型训练,每一轮给出 feedback 作为下一轮的输入;
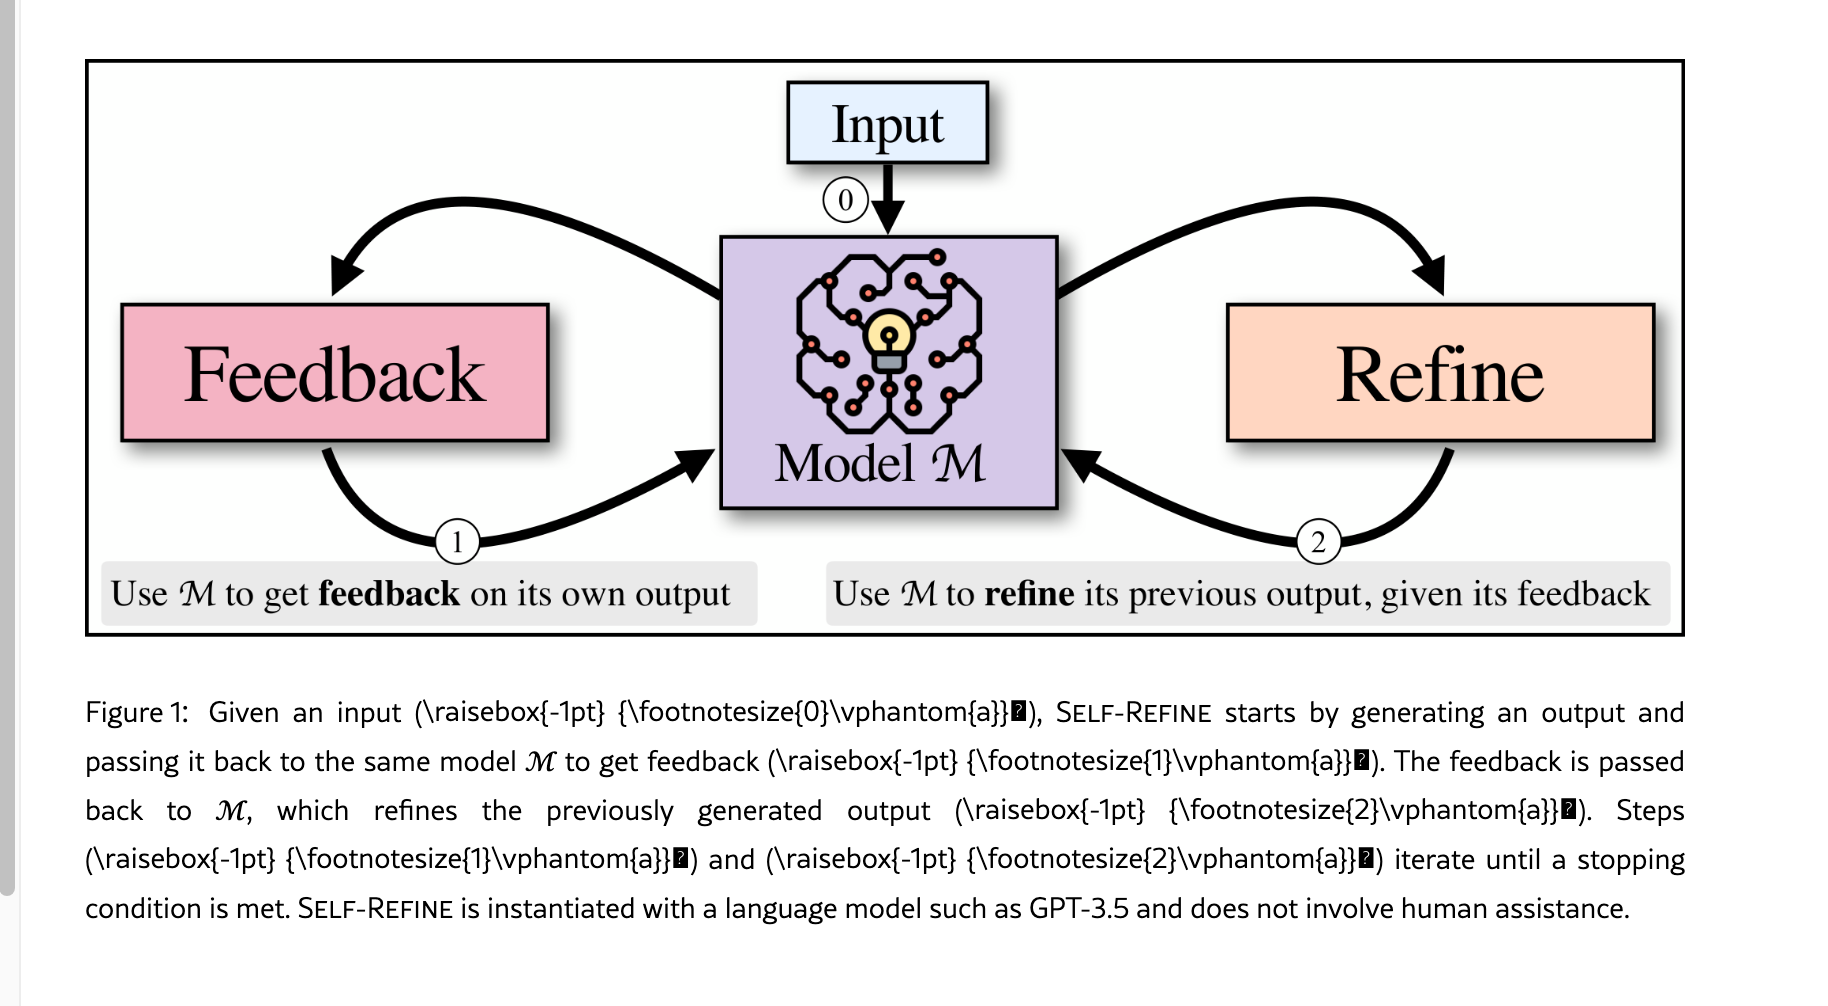
观点:方法论比较简单,没什么可评价的。
Reflexion: Language Agents with Verbal Reinforcement Learning
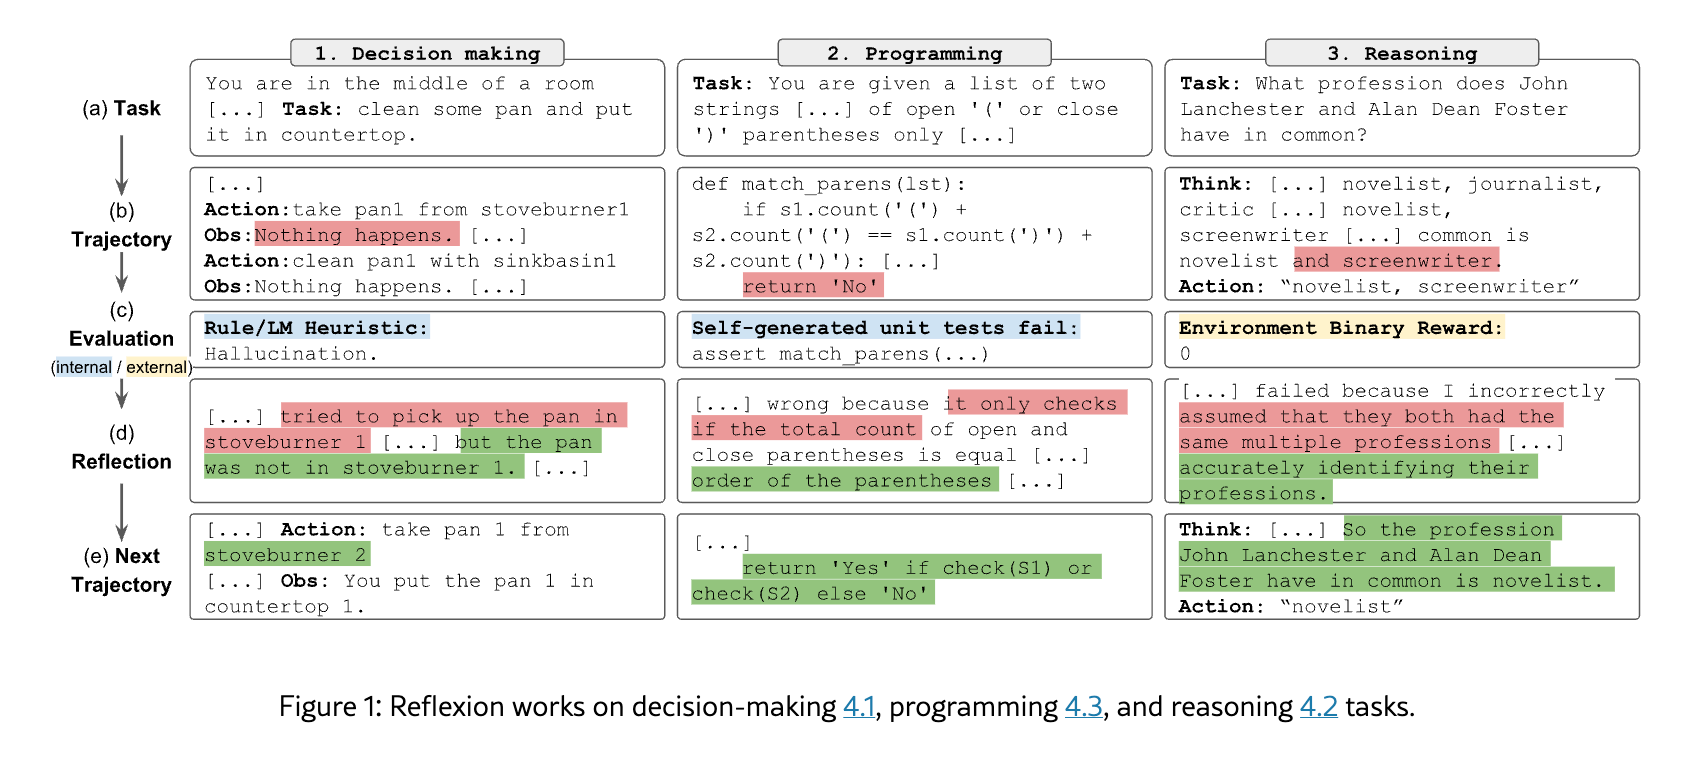
- 也是 23 年,姚顺雨提出的,https://arxiv.org/html/2303.11366v4,相比 Self-Refine,多了一个记忆过程,把历史经验存储下来,供下一轮读取。
FunSearch: Making new discoveries in mathematical sciences using Large Language Models
- DeepMind 23 年底提出的,背景是数学问题中存在不对称性,校验一个解很容易,但是发现一个新的解题方法却很难。
- 方法:人类提供问题框架、初始程序和评价函数(就是现在一个 RL Environment 的定义?),用 database 存储 LLM 探索的所有解法,然后让 LLM 在不断的探索中去找到新的解题思路,并将有效候选放回 database 里。
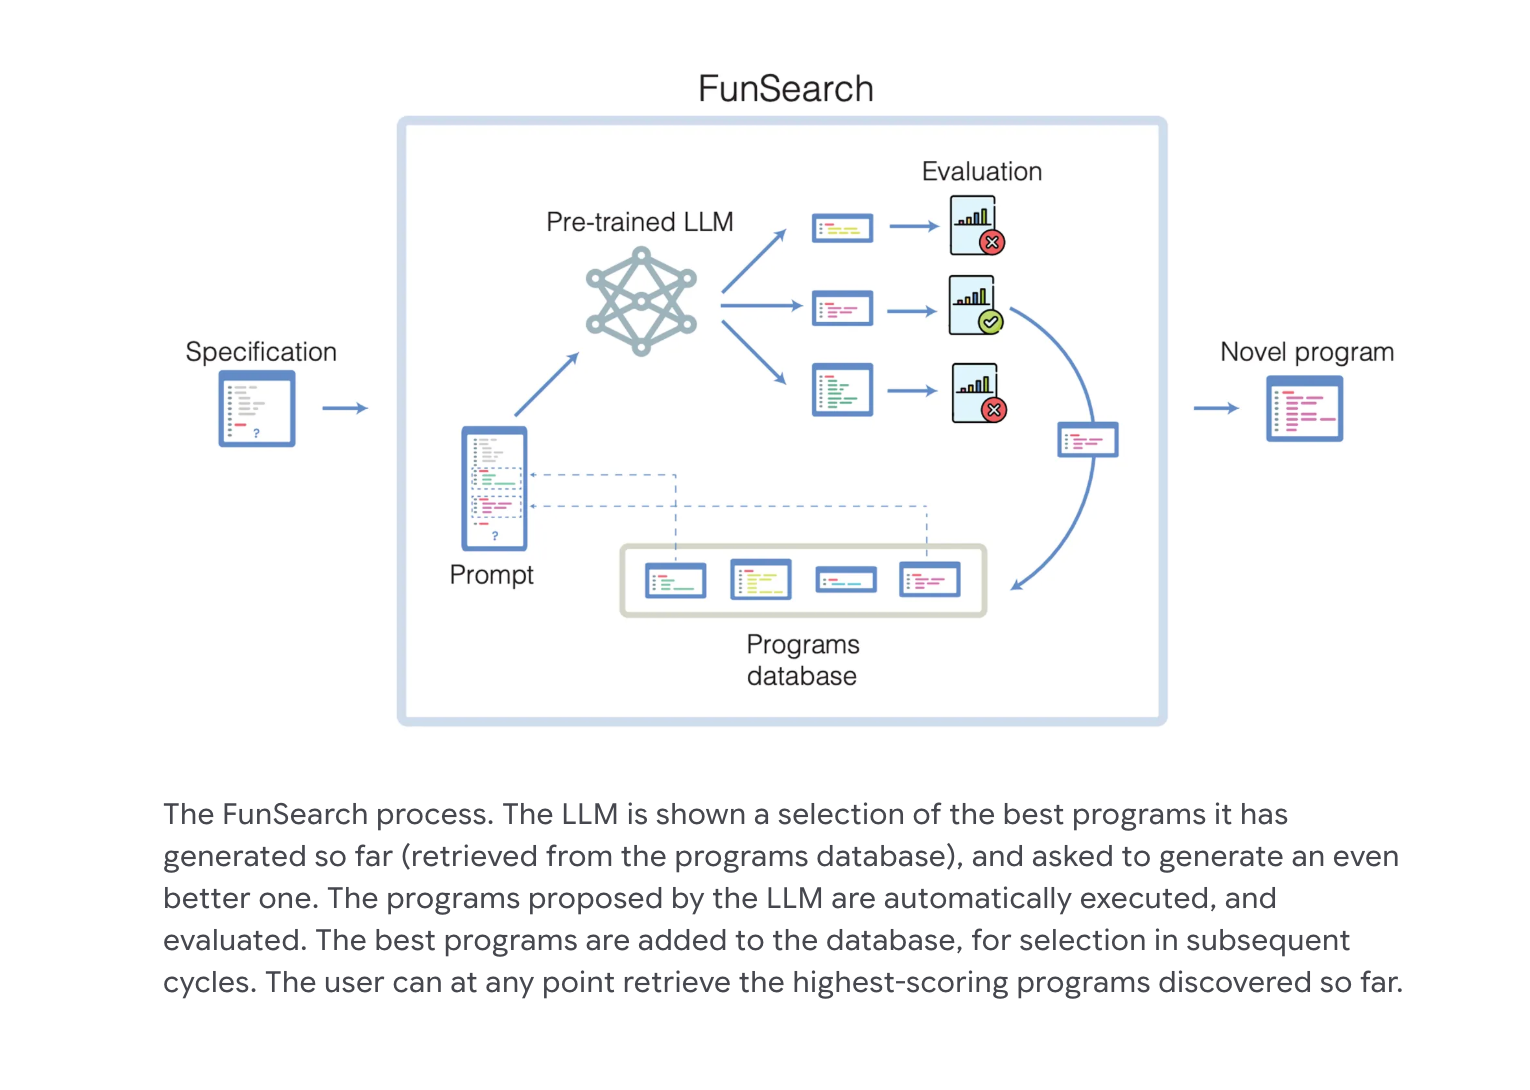
这里有个关键点:怎么让每次的 dicovery 方向足够多样性,而不是在一个”死胡同“里不断调参,浪费 token? FunSearch 的解法是,会用 LLM 对每个解法做一个 cluster 划分,然后每次生成的时候,带有一定随机性的从某个 cluster 里选 program 作为起点开始迭代。
L2:把 Agent 自身当做改进对象
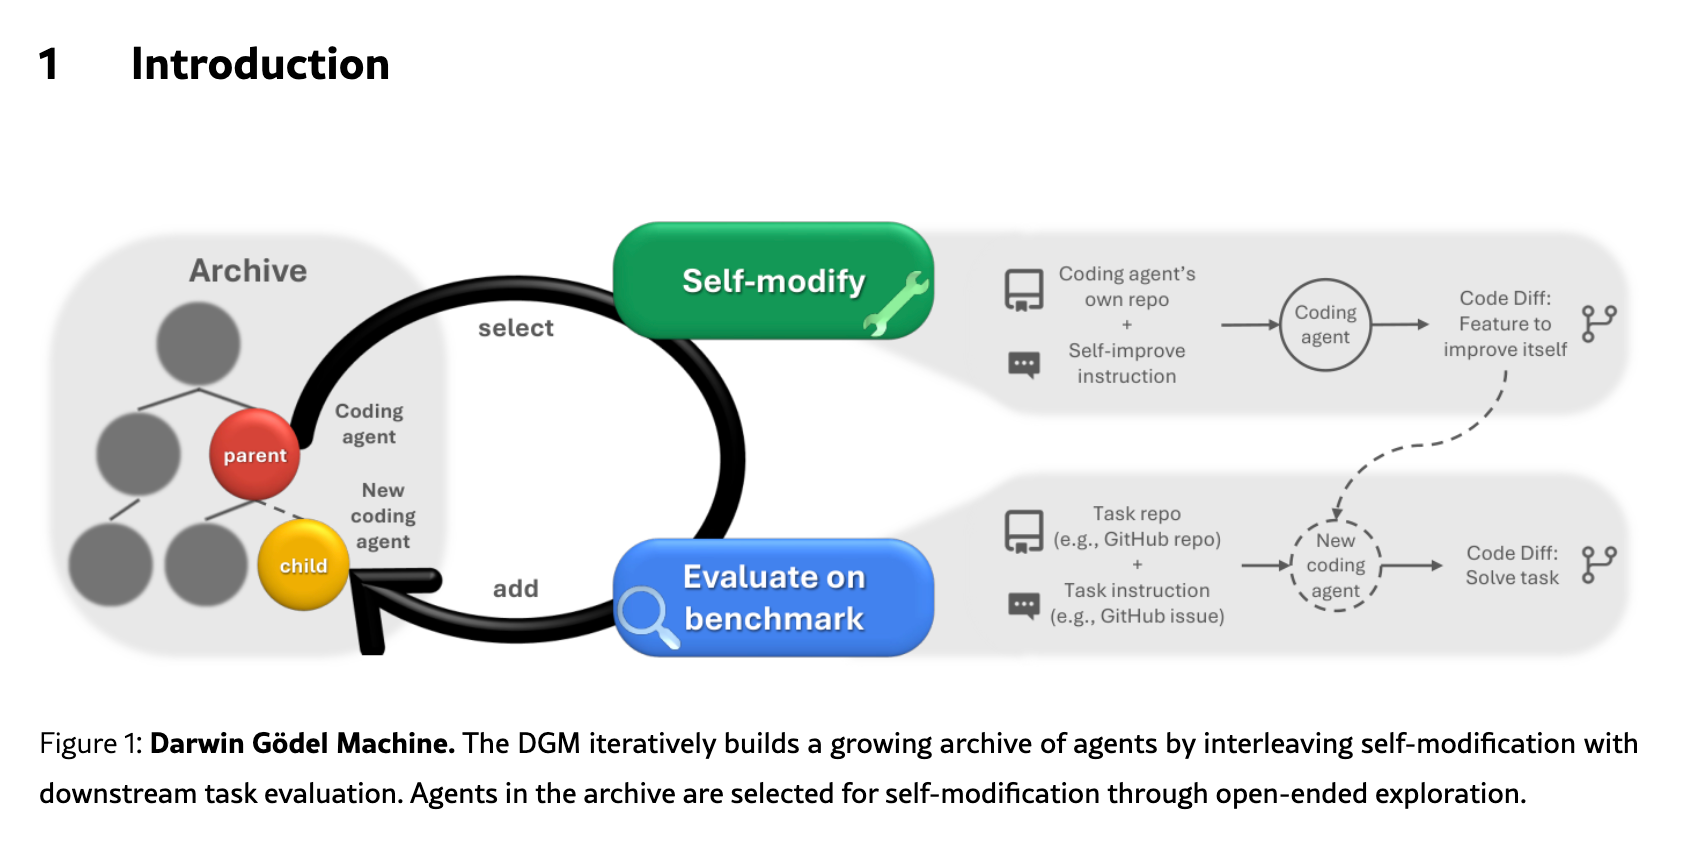
Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents
- 25 年 5 月提出的,https://arxiv.org/html/2505.22954v1,背景是当前的 Agent 迭代里,architecture 都是固定的,LLM 的能力受到 Agent 的限制,所以想把 Coding Agent 本身的逻辑也当做可以迭代的内容;
- 方法:核心还是明确好 Evaluation 的能力,在已有 Eval 的基础上迭代 Code,同时保留好”短期“内退化的 program,可能长期有更大的收益。
L3: 寻求更优的 Exploration 策略
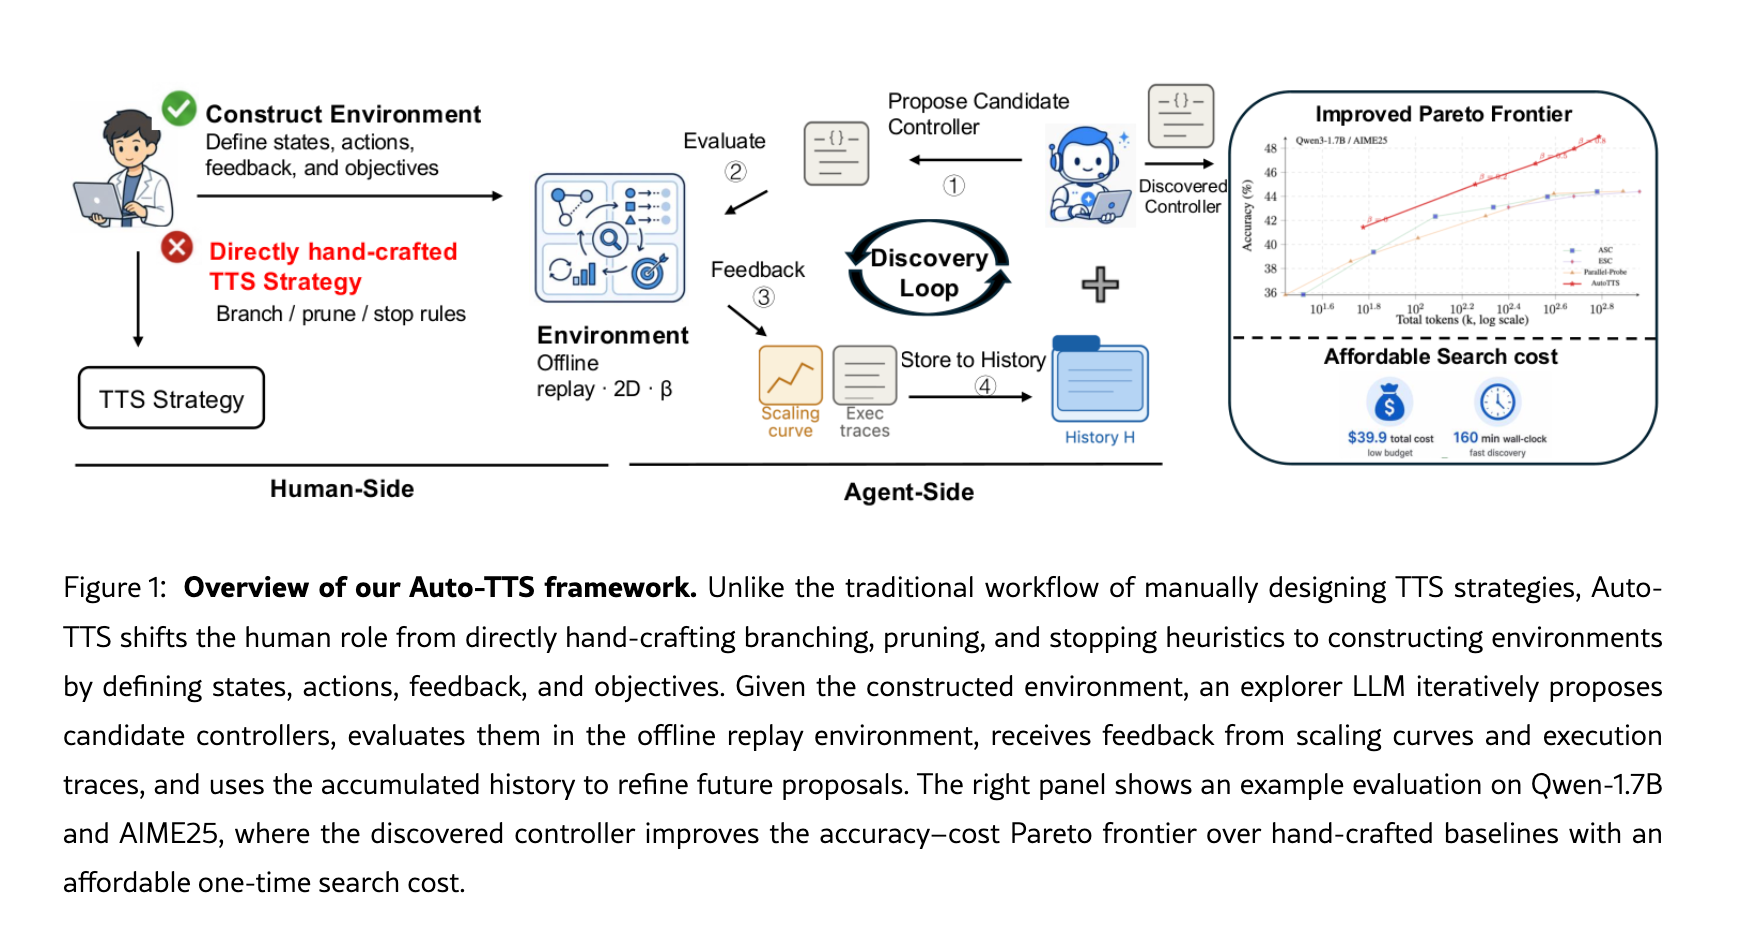
Auto-TTS: LLMs Improving LLMs: Agentic Discovery for Test-Time Scaling
- 也是今年发的一篇 paper,https://arxiv.org/html/2605.08083v1 ,Test-Time Scaling 的含义:推理时在 response 侧投入更多的计算,以提高答案质量的过程。
- 背景是当前 Test-Time 的 Scaling 都是依赖人工定制的策略,如果想要更加高效的拓展,完全可以通过采样获取大量长程 rollout 轨迹,然后把每条策略变成长程的多个选择题。每个步骤的推理中,每隔一段 token 就做一次 probe,存储中间状态等待未来决策时再进行回放。
举个实际例子:
假设你运营一个数学解题服务。固定策略是“每道题都生成 64 份完整解答,最后投票”,容易在简单题上浪费计算。AutoTTS 发现的控制器可以根据中间信号调度。下面是示意流程,不是论文控制器的精确规则:收到一道题 ↓先启动 4 条推理链,每条推进一段 ↓probe:让各条链根据当前进展给出暂时答案 ↓┌─ 答案一致,并且后续检查仍稳定 → 提前结束│└─ 答案分歧较大 → 继续部分分支,或增加新分支 ↓ 再检查,直到停止这里的 probe 不是读取标准答案,也不是告诉系统哪个答案正确,而是获得当前推理前缀对应的暂时答案。答案一致只是可用于决策的信号,仍可能一致地答错。观点:不是很赞同这个路线,相当于把 Test-Time Scaling 都变成了离线轨迹采集和选择,实际应用场景中,很难有一模一样的问题,以及限制了模型拓展新路线的能力。
Dream-RSI: Recursive Self-Improvement through Evolving Worlds
- 26.09.14 由 DeepMind 提出的 https://arxiv.org/html/2609.14858v1,
- 背景:因为现在 LLM 领域都在追求 Long-Horizon 的 Agent Task,而后训练数据又主要是依赖数据合成,所以合成方向的 exploration 是一个相当重要的问题(如何找 ROI 更高的 exploration)
- 解决方案:把每个 exploration 看做是 discovery tree 上的节点,每个节点对应的 simulation environment 和 input/output,过程都尽可能做完整记录。
- 举个例子:
假设你希望把一个算子从 10 ms 优化到 5 ms。以下是示意:固定的编码 Agent 同时尝试三个方向:
A:修改内存访问方式   10 → 8 → 7.8 → 7.8 msB:调整并行组织       10 → 9 → 7   → 6   msC:融合计算步骤       正确性测试连续失败接下来有很多调度选择:- A 已经停滞,还要投入多少次修改?- B 持续改善,是否应该继续?- C 应该再给一次修复机会,还是停止?- 是否需要从头开启新的方向?写出下一版 kernel 是编码 Agent 的工作;决定让谁继续、什么时候换方向,是探索策略的工作。Dream-RSI 用历史探索记录比较这些调度规则,再把选出的规则用于后续真实探索。它不会因为停止了 C 就知道 C 永远没有价值,所以策略仍需平衡短期收益与探索机会。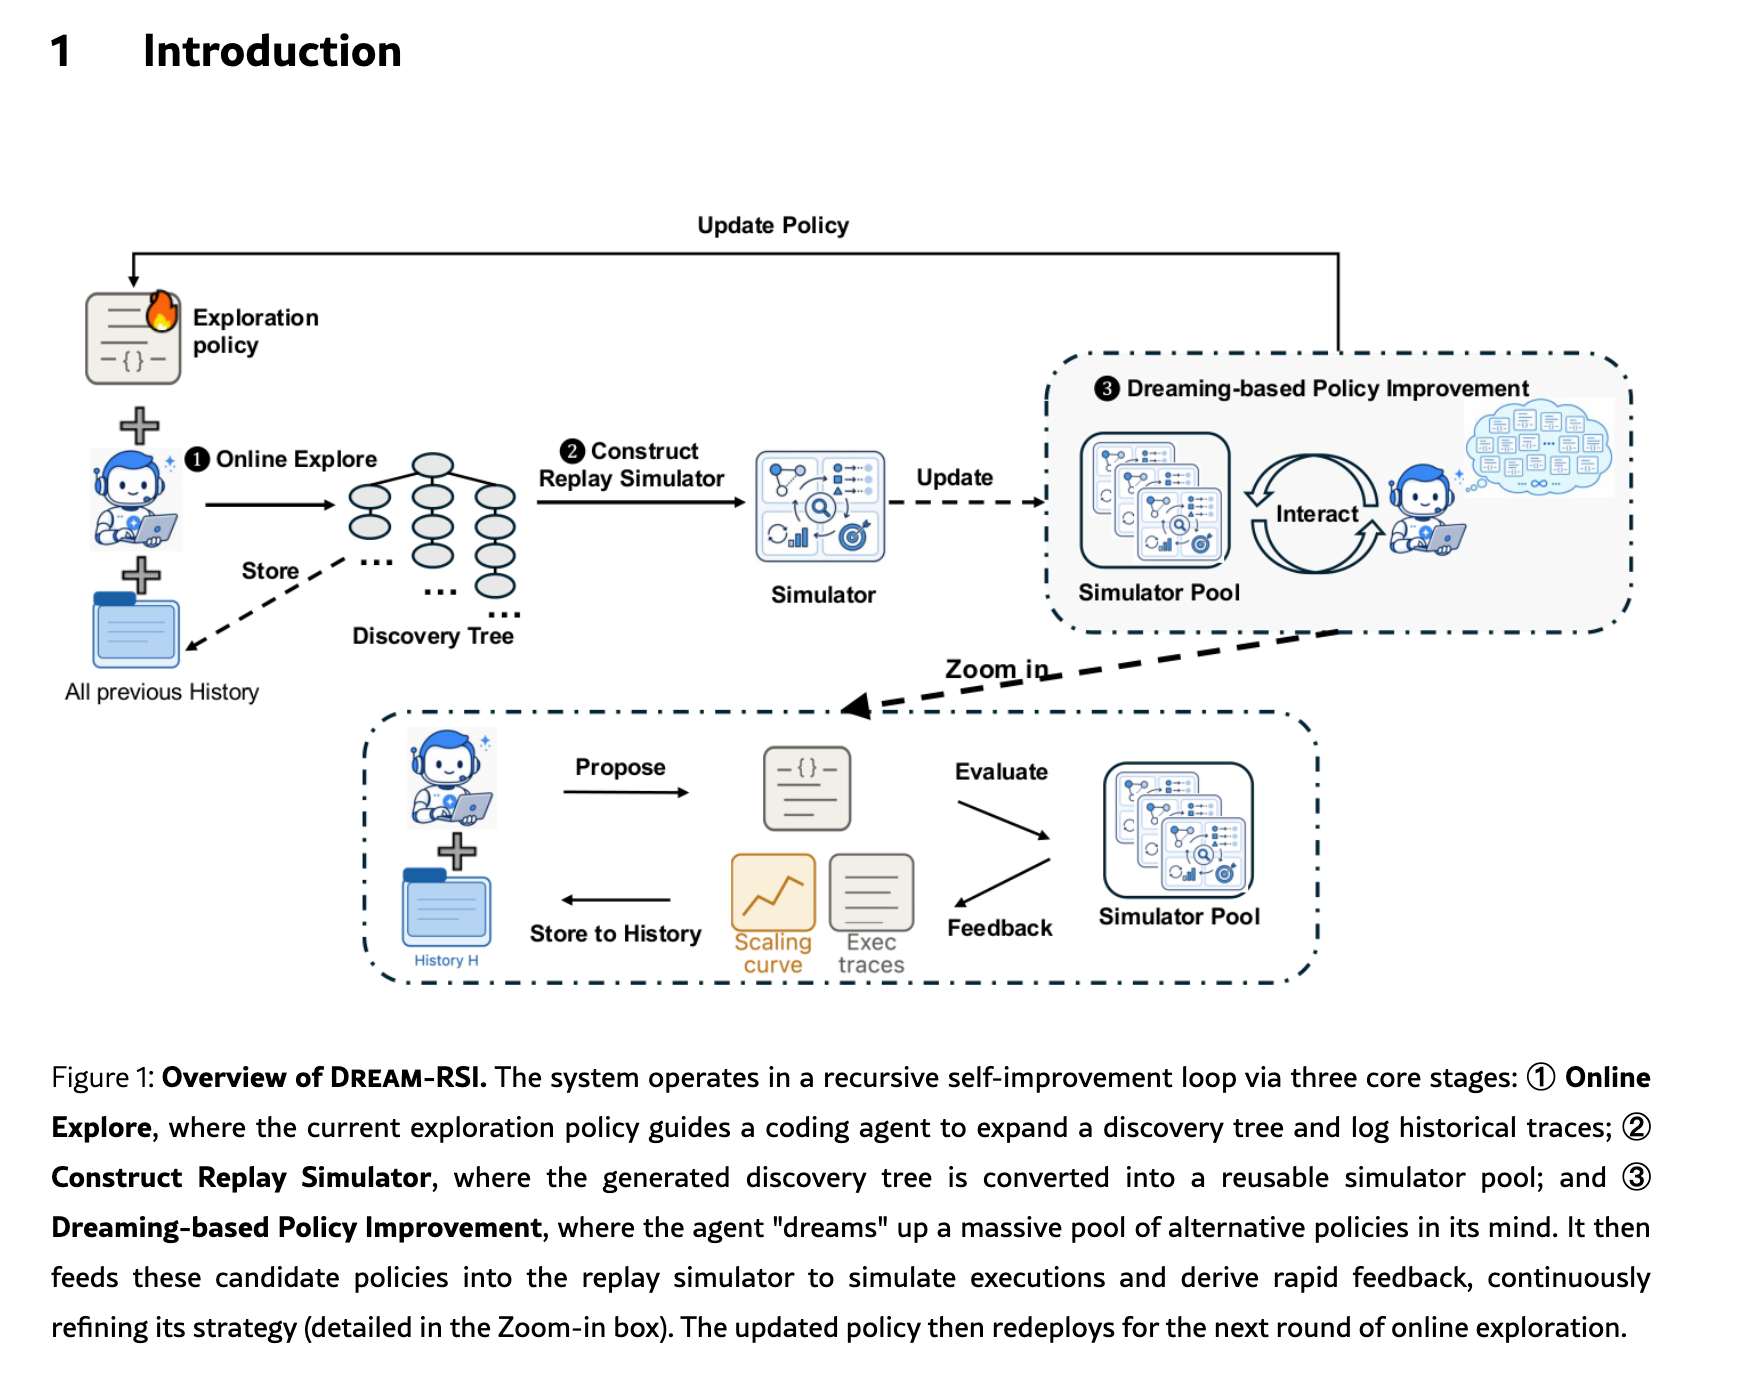
L4: 自己出题,自己解?
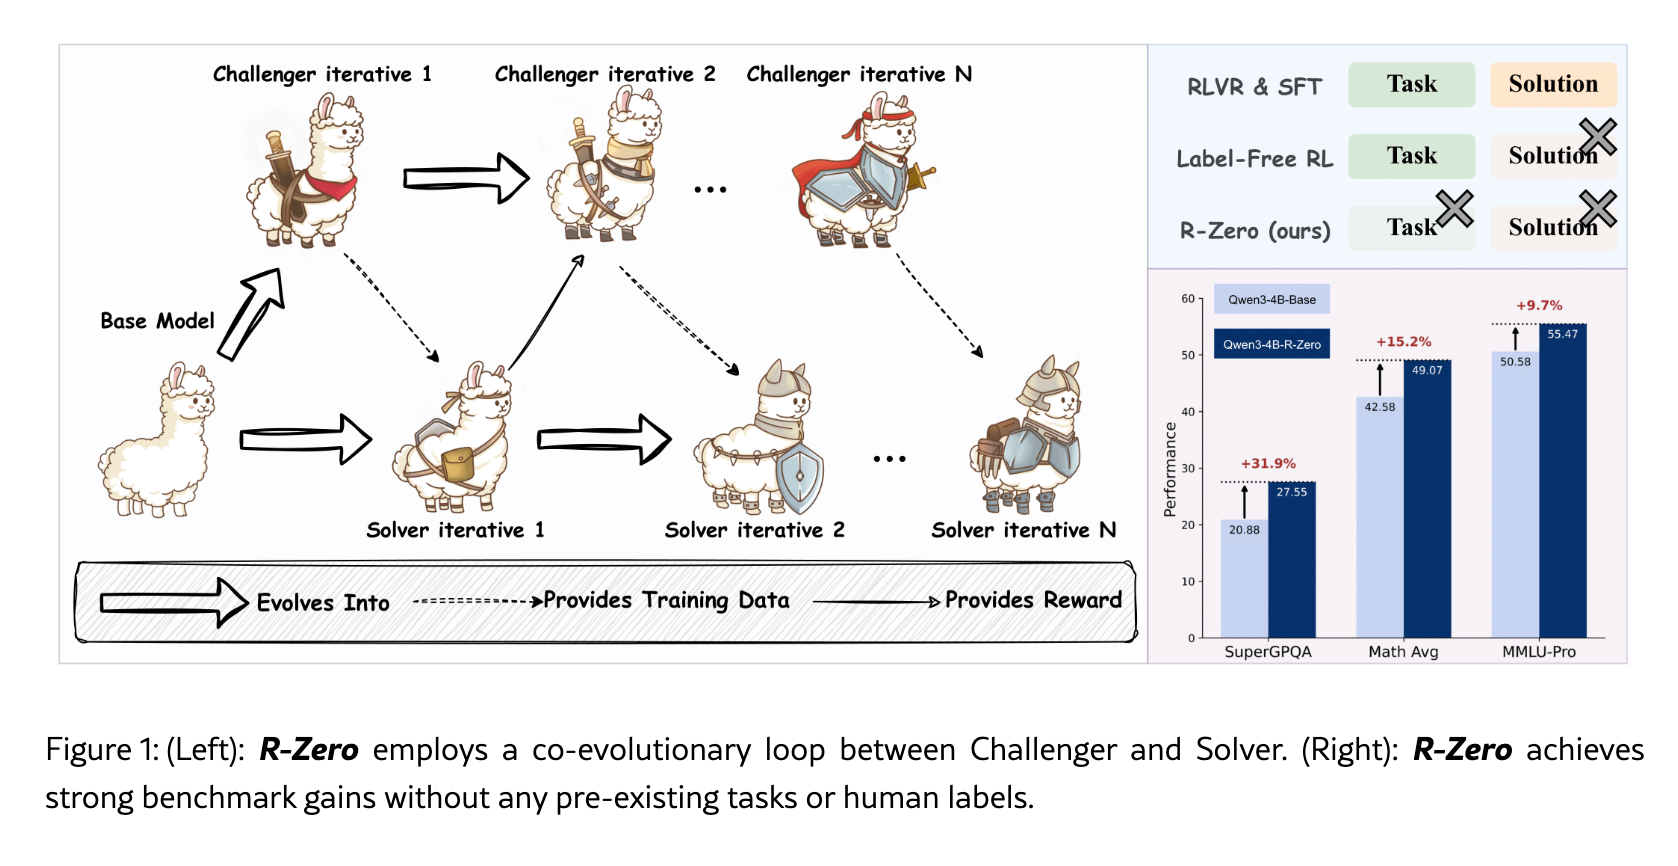
R-Zero: Self-Evolving Reasoning LLM from Zero Data
- Tencent AI Lab 发的,https://arxiv.org/html/2508.05004v4
- 背景和方法:还是回到数学问题上, R-Zero 想着用两个 model
- Challenger: 核心 reward 是出的题够难;
- 训练时使用 uncertainty reward 和 repetition penalty,通过固定 solver 然后答题成功率来判断难度;(核心点是不能出太难的题目,但是这种 RSI 很有可能会出错误的题目,尤其是碰上 Solver 乱答就会变得越来越差)
- Solver: 核心 reward 是解题的正确率;
- Challenger: 核心 reward 是出的题够难;
EnvHarness: Awakening Static Worlds for Agent Learning
- Google AI Research 发的,https://arxiv.org/html/2608.19880v1
- 背景:Agent 可以在浏览器、代码仓库或操作环境里练习,但人工环境往往固定:相同任务、相同起点、相同反馈。继续收集轨迹,可能只是在反复练习已经会的行为。从零生成环境又会带来另一种负担:环境逻辑可能出错,奖励和 verifier 也要重新设计。EnvHarness 的思路是:保留已有环境与验证基础,在标准接口外增加一层可编程包装,让练习条件随 Agent 的弱点调整。
- 解决方案:核心思想是 “根据 Agent 当前的能力和弱点,通过环境包装层调整它遇到的联系条件”,这里面包含两个模块:
- EnvHarness: 直接改 Environment(基于原始 env 有层封装)
- EnvRigger:观察 Agent 策略表现,分析弱点和更改意见
Agent 在当前环境执行任务 ↓EnvRigger 分析成功与失败轨迹 ↓诊断:哪里不会?哪里太简单?是否依赖脆弱捷径? ↓编写 EnvHarness 包装组件 ↓让 Agent 在新环境中实际尝试,验证是否可解、是否有练习价值 ↓Agent 从练习中学习 → 再诊断、再调整环境观点:这个其实是 RL 里常见的做法,就是 Model 太“菜”的话,就直接根据他的能力来做打标,以此获得所谓的“正样本”。只不过这里应用到了长程的 Agent 任务上。