Personal Agent 和 Memory

梳理 Agent Memory 的技术路线和业界实践,从外部记忆、模型内状态到参数更新,Memory 如何让 Agent 变得足够智能和个性化?
之前写过一篇 Continual Learning,智能的下一个方向?,当时比较关心的问题是:在 Pretraining 和 Post-Training 之外,模型能不能随着用户使用,不断接收反馈,学到新的知识和能力?
序
这篇文章围绕着 Agent Memory 的主题,讲了几条技术路线,如外部 Memory、Memory 在模型内化、模型参数持续学习、Hybrid 架构等模式。一方面我想看看前沿的最新进展有什么,另一方面是看看这些研究到底是否真的有落地到工业界的可能性。
从使用者的角度来看,我们期望 Personal Agent 的智能其实很直接,就是期望 Agent 像人一样“懂你”,我觉得 Memory 的处理是其中最关键的地方,因为我们大部分日常生活的信息输出并不来源于所谓的 “Wiki“ 百科,而更多是来源于即时发生事情的”即时反馈”,那这和我们刷抖音和 TikTok 的思路就很像了。
所以我一直在想,推荐系统的思路是否和 Personal Agent 会有共通的地方,推荐系统的 Memory 本质上是一个个 Feature(特征),所以推荐系统往往有个重要组件叫做 Feature Store,这些 Feature 会作为每次推理的重要 input。
当前业界对于 Memory 的处理,有 3 个方向:
- 外部记忆:保存历史,写入文件系统,一个个 Markdown 文档;
- 模型记忆:类似 TTT(Test-Time Training) ,每次 input/output 都是更新记忆的 hook;
- 混合路线:外部记忆(离线) + 模型记忆(实时)
下面先看方案,最后再回到这个类比。
外部记忆
外部记忆的基本流程比较直接:
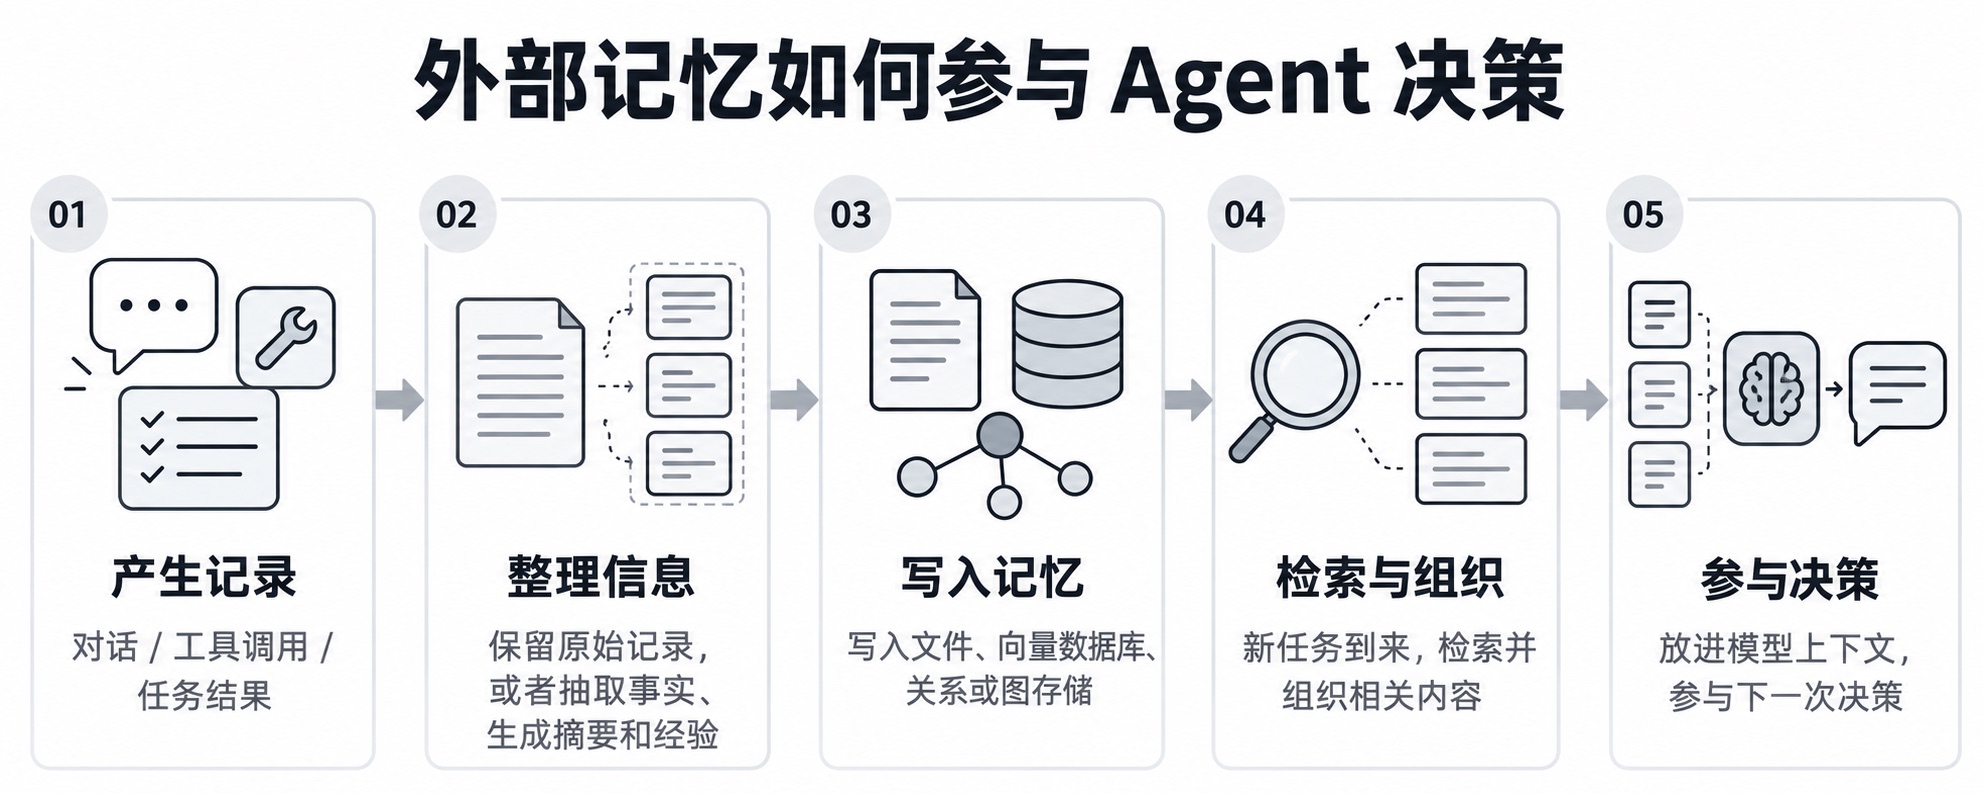
文件式记忆
Claude Code Memory
Claude Code 的官方记忆文档 把两种机制分得很清楚:用户编写持久指令,Claude 自己记录从纠正、偏好和工作中得到的经验。
- 指令可以放在 managed policy、user、project、local 等不同作用域的
CLAUDE.md文件里。 - Auto-memory 存储在项目对应的 memory 目录,用
MEMORY.md作为入口;启动时加载前 200 行或 25KB 范围内的内容,其他主题文件按需读取。 - 文件层级定义的是作用范围和加载关系,并没有表达“压缩”的概念。
Dive into Claude Code: The Design Space of Today’s and Future AI Agent Systems 里对 Claude Code 的 Agent Memory 使用做了一个详细的解读,里面讲到它用的也是一个上下文管理,而不是用这个 Memory 去微调它的模型,本质上是一层模型外部的 Harness。
使用文件的问题也很大,比如说:
- 文档内部不一致:最近有个很火的项目叫 deepseek-harness,这是一个完全由 AI Vibe 的项目,里面大量使用 doc,可以看到很多 Issue 都是关于 .md 文档的错误,我觉得长期演进下去,这个项目就会成为一个“屎山”。(虽然是来自于 Deepseek….)
- 文件索引不好做:相比于 embedding 的召回,文档的 retrieval 有各种各样的方式,但很难说每次都能召回出用户真正想找到的东西。(举个例子,你可以尝试一下问 Claude Code 你一个月前的一个工作,看看它还能不能准确地讲出来)
Everything is Context / AFS
Everything is Context / AFS 系统地把记忆组织成了一个具有一定 structure 的文件系统目录结构:
| 区域 | 作用 | 生命周期 |
|---|---|---|
/context/history |
保存历史事件和交互 | 不可变、追加 |
/context/memory/agentID |
保存加工后的经验、摘要和索引 | 可更新、长期存在 |
/context/pad/taskID |
当前任务的临时工作区 | 短期、可审计 |
这个拆法其实和工程系统里的日志、派生视图、临时状态有点像。原始历史保留以后,摘要出错还可以重新生成;当前任务的中间猜测,也不必马上进入长期记忆。
观点:这个方向的价值首先在工程上可检查、可重建、可区分临时信息和稳定信息,都是长期运行时会遇到的真实需求。至于采用这种目录结构能提升多少任务成功率,需要另外做实验。
向量、分层与图记忆
Mem0: 向量检索
Mem0: Building Production-Ready AI A=gents with Scalable Long-Term Memory
背景/痛点:长期对话里,有用信息往往分散在大量零散的会话里,
- 如果把全部历史塞进上下文,会增加成本和延迟;
- 直接对原始数据进行切块检索,又可能混入无关内容、重复事实和已经过时的信息;
方案(如下图):
- 抽取事实:结合新一轮对话、近期消息和历史摘要,让 LLM 提取值得保留的信息。
- 查找旧记忆:用 embedding 检索语义相近的已有事实。
- 决定如何更新:让 LLM 对比新旧信息,选择 ADD、UPDATE、DELETE 或 NOOP。
- 按需调用:新问题到来时,检索相关记忆,将记忆文本放入模型上下文。
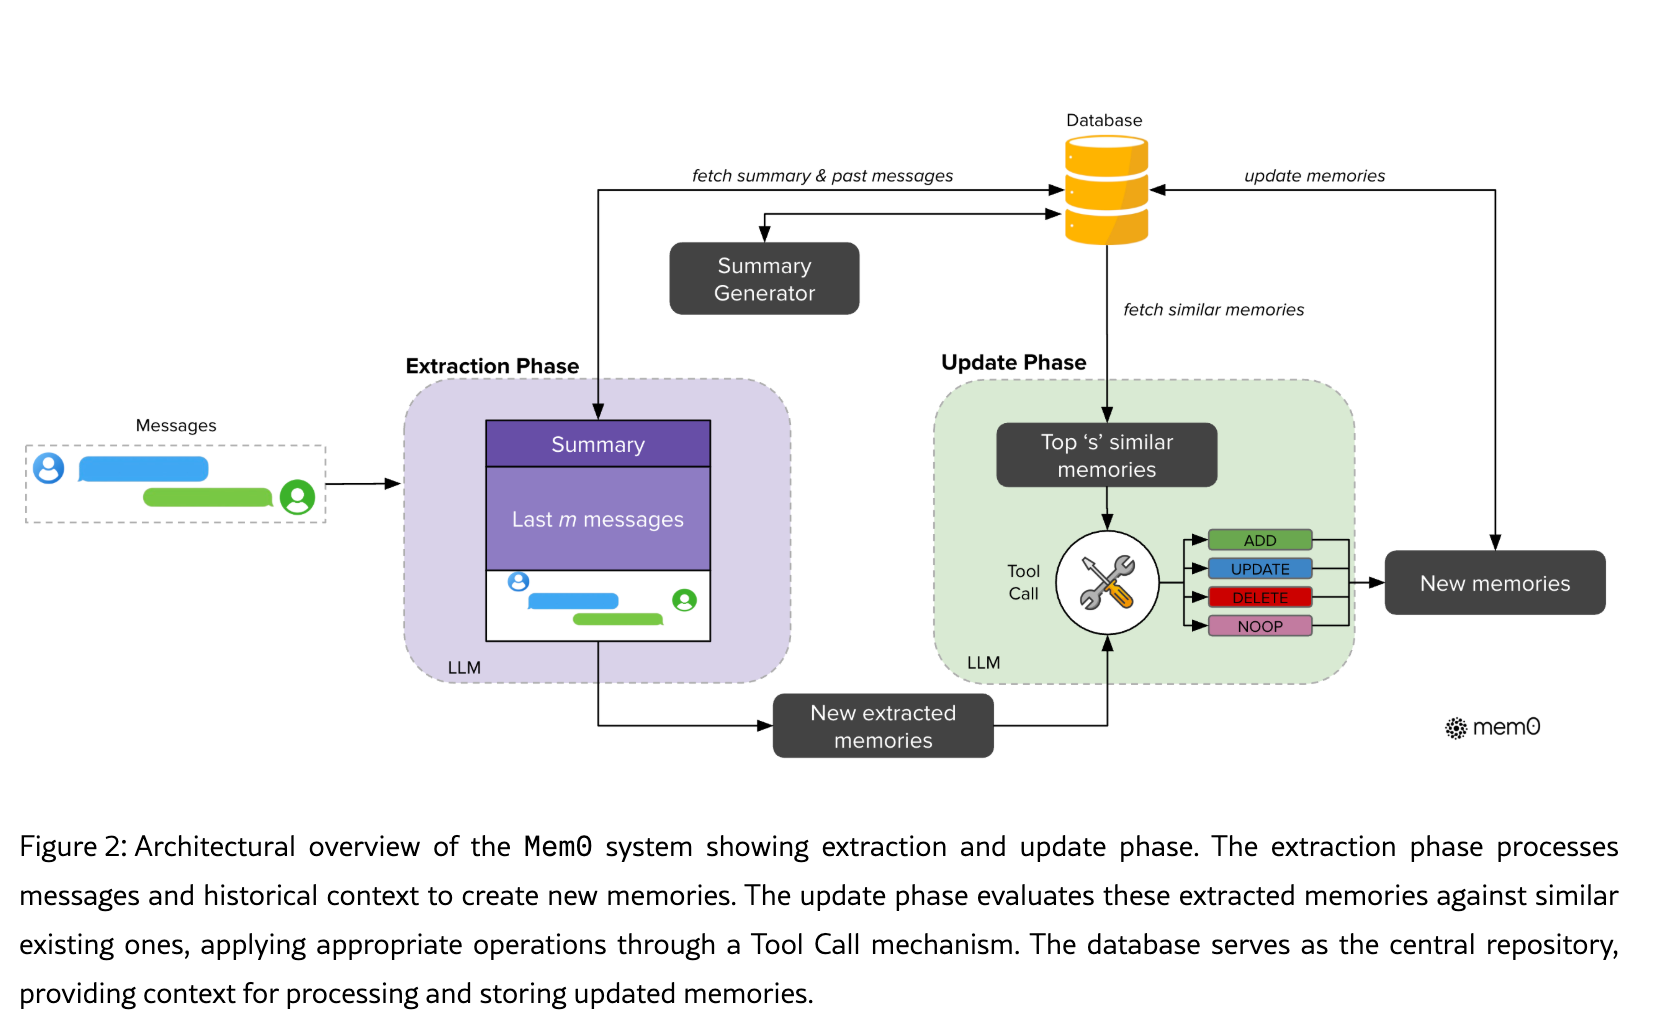
观点:这是挺朴素且最实用的 Memory 方案,也是现在被广泛使用的方案。
MemoryOS: 分层记忆
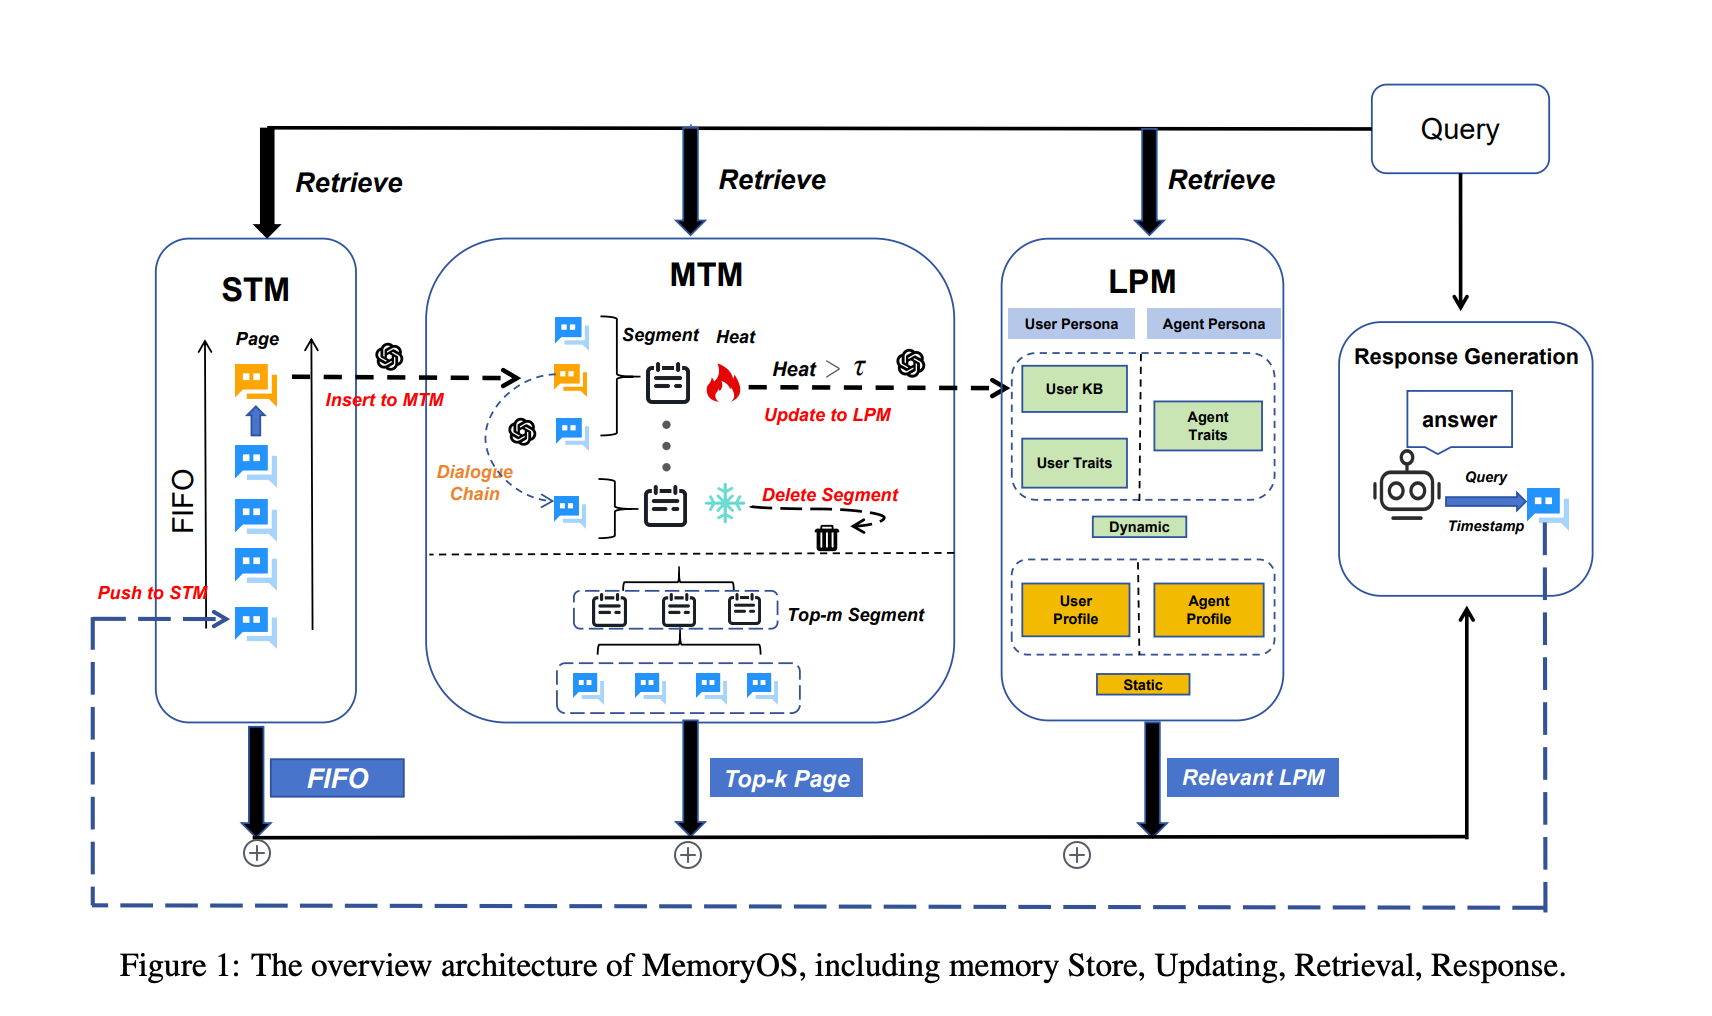
背景/痛点:最近几轮对话需要保留细节,历史讨论需要按主题查找,用户偏好则需要长期积累。对这些信息采用同一种存储和访问策略,容易出现主题混杂、重要信息被挤掉,以及用户画像不连贯的问题。
方案:三层架构
| 层级 | 保存内容 | 访问方式 |
|---|---|---|
| 短期记忆 STM | 最近对话及其上下文关联 | 整体进入当前上下文 |
| 中期记忆 MTM | 按主题组织的对话页和摘要 | 先检索主题,再检索具体对话 |
| 长期记忆 LPM | 用户与 Agent 的画像、偏好和事实 | 画像直接使用,事实按相关性检索 |
Graph
Zep: A Temporal Knowledge Graph Architecture for Agent Memory
背景:LLM 里最常见的 RAG,主要适用于静态信息,对于关系频繁发生变化的信息是没有办法做到准确,比如“用户曾在 A 公司工作”和“用户现在在 B 公司工作”可以同时成立。
方案:核心思路是用 Graphiti 将记忆组成 3 个部分:
- Episode Graph: 原始对话 Episode -> 对话里的某个 Entity
- Entity Graph: Entity -> Entity
- Community Graph: 一组 Entity 构成了 Community
这个方案还挺有意思的,核心是如何构建 Graph:
- 原始输入经过 LLM 后,抽取出 Entity(比如 “小王在公司 A” 工作,里面有“小王”和“公司 A“两个实体)
- 大量 Entity 的连接,可以用图算法做簇
- Retrieval 时可以直接从 Entity 的 Embedding 做抽取然后返回指定 depth 的 episode
从轨迹里抽象 Memory
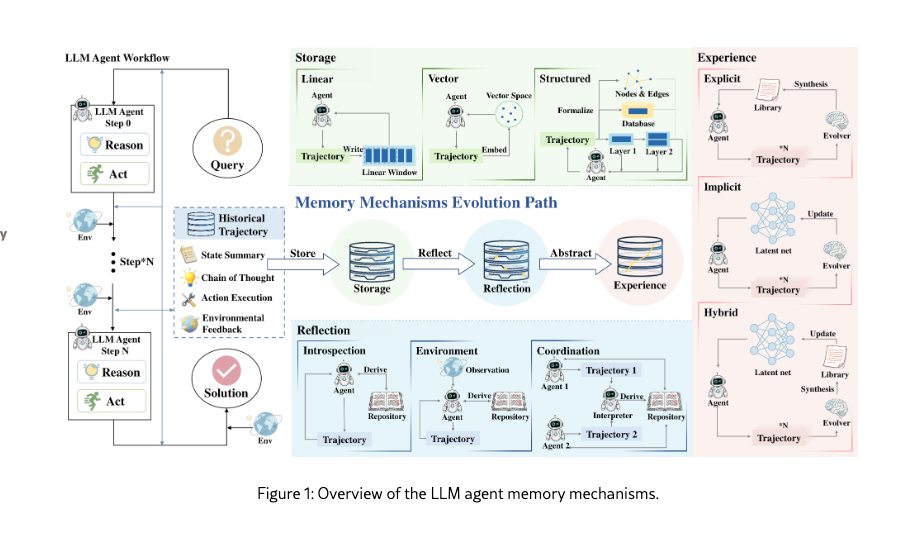
From Storage to Experience
背景:LLM 既有的 Memory 方案比较碎片化,不具有 evolve 的特点。 方案:提出 Memory 的三层设计
- Storage: 存储原始轨迹
- Reflection: 从原始轨迹里“反思”
- Experience:从 Reflection 里抽取通用“经验”
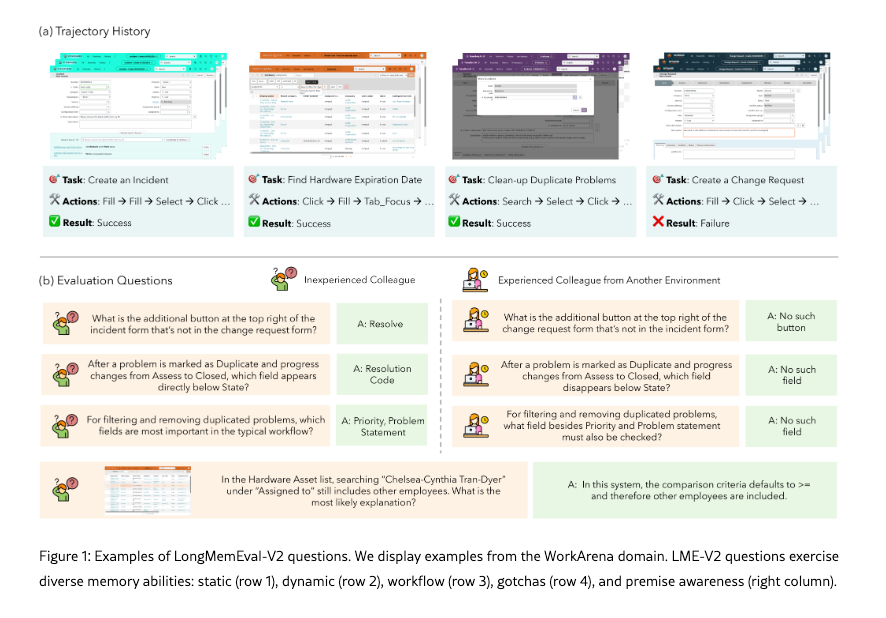
LongMemEval-V2
背景:记住用户偏好,与熟悉一个具体工作系统,是两种不同的能力。长期使用业务网站的 Agent,还需要知道页面结构、操作后果、任务流程和常见陷阱。 方案:这个方案有点像是把 eval 和 memory 结合起来了,不是单纯记忆,而是把一个 agent 轨迹的前因后果都给记下来
Sleep-time Compute / Dreaming:预测用户需求
Sleep-time Compute
25 年 4 月发布的。
背景:Test-Time 的 Scaling 能提升模型推理效果,但是在 latency 和 cost 上有损。 方案:这篇 paper 期望在 offline 里去“预测”用户需求,提前计算好对应的 cot,有点像是offline Test-Time scaling。如何预测用户需求?
- Context 作为线索
- Prompt 出任务
- 推理出结果和存储
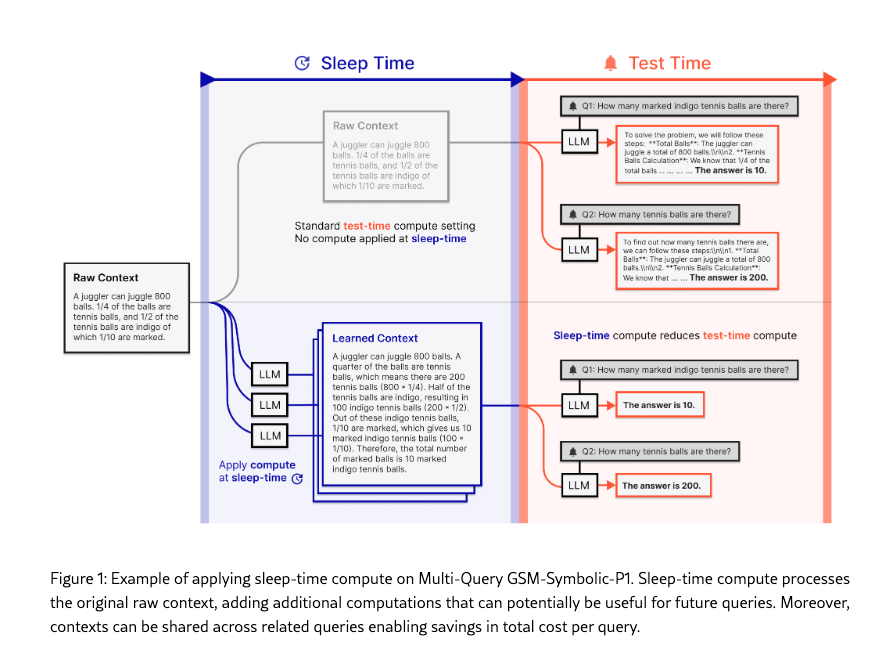
观点:挺适用于某些固定场景的,比如常见的数据分析,分析方法和聚合维度都是有限的情况下,完全可以基于业务特点和有限的数据方法论做好提前计算。(可能是一个有机会的点)
Letta 当前的 Memory & Dreaming 文档
Letta 是 MemGPT 的商业化公司,主要做 Continual Learning 和有记忆的 Agent。方法论和上面 Sleep-Time Compute 类似,区别是这里离线计算用的是用户过去一段时间的交互轨迹而不是 raw text。(Sleep-Time 更偏知识类问答)
Karpathy 在 2025 年的访谈
几个 key points:
- 预训练解决了吸收知识和问答能力,但本质上获取的是一种“模糊记忆”
- 上下文提供的是更直接的信息访问方式,会比“模糊记忆”更可靠
- 如何将“经历”变成权重,他设想模型回顾交互、反复分析、生成合成训练数据,再把结果蒸馏回权重;个性化更新可能通过 LoRA 等局部参数实现。重点是让交互产生的学习超出当前上下文的寿命。
注:仍没有共识的解法。
模型在推理时记忆
TTT(Test-Time Training)
Training 指的是在 Test 或者 Inference 的过程中,也能训练模型,而不是只在 backward 阶段去更新模型 weights。
这里主要是结合 RNN 和 Attention 的思想:
- RNN 有压缩记忆的能力,不断把历史信息压缩到一个指定 dim 的 RNN 单元里,这种模式有信息遗忘的问题,所以有 LSTM 这种门控机制来控制信息遗失(但是门控依赖模型的人为设计);
- Attention 是针对所有 token,做一次 O(L^2) 的 attention 计算,没有信息遗失但会造成超长 Context 场景下计算复杂度的问题;
而 TTT 结合两者特点,有 Linear 和 MLP 两种模式:
- TTT-Linear:不带 backward,在 hidden states 的基础上做一个 Linear 小模型,采用 RNN 的方式,根据新的 hidden states 去更新小模型的 weights,小模型的 weights 就是历史所有 Input(也是 hidden states)的压缩;
- TTT-MLP:和 Linear 模式类似,只不过加入了非线性层,能够进一步挖掘到 hidden states 的内部交叉信息,并且通过 backward 来更新 model weights;
Titans: Learning to Memorize at Test Time
Titans: Learning to Memorize at Test Time,2025.01 Google 的工作。
本质和 TTT 是一样的,区别是引入了更复杂的 MLP 和模型结构设计,引入动量与自适应遗忘,信息准入等。
Nested Learning / HOPE:不同频率的记忆
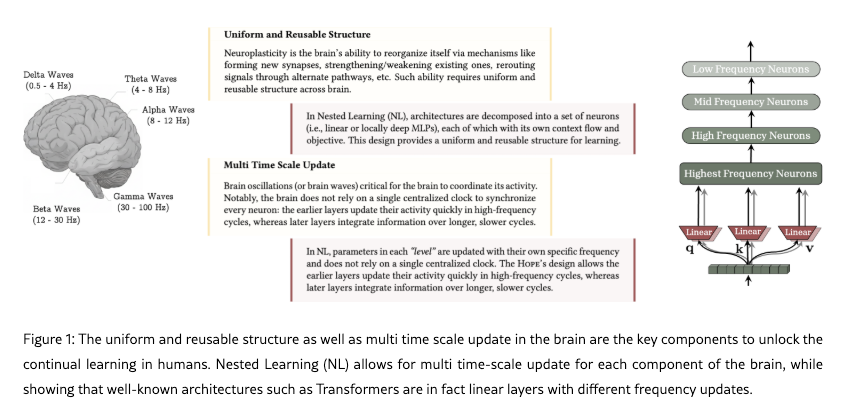
Nested Learning,NeurIPS 2025.12 发布的,还是 Google Search 的工作,和上面是同一批人。
在原有的模型结构上,增加了不同 Time-Scale 的 Layer,有点像推荐系统里的短窗口/长窗口特征,短窗口特征会实时变化,长窗口可以做到 T+1 或者 T+7。这样的目的是让历史知识的推理不受影响,同时近期知识能够尽快被模型吸收。
- Nested Learning: 把模型及其优化过程看作相互关联的多层学习问题,每层有自己的信息流和更新频率。
- 结合能学习自身更新机制的 Titans 变体,以及连续多时间尺度记忆系统 CMS(Continuum Memory System);
The Surprising Effectiveness of Test-Time Training for Few-Shot Learning
观点:25 年发的,整体思想是遇到新场景,做一批数据合成,然后 SFT 训进去,和我们现在的 fine tune 没有本质区别。
Macaron-V1:模型与 Harness 一起迭代
On the Scaling of PEFT δ-mem: Efficient Online Memory for Large Language Models Macaron-V1
这几篇 Paper 之前有过解读,见:https://www.liaojiayi.com/blog/continual-learning#mindlab
新的 Memory 持续训进模型不是无损的
三篇 Paper 一起看:
- Sequential Knowledge Editing
- 26 年 9 月的 paper,在 Qwen2.5 上做了 perplexity 测试,如果注入虚假信息、真实更新,即使 MMLU 的分数不变,但 perplexity 的变化明显;
- AlphaEdit
- 24 年 10 月的一次探索:AlphaEdit 将更新投影到旧知识表示矩阵的零空间,结论是通过一个矩阵映射的约束,能够让新的知识 ingest 成功,但不能保证问答完全无损。(取决于旧知识训练数据)
- Model Editing at Scale
- 单次知识编辑成功,不代表同一个模型可以长期接受更新。新事实能回答正确时,之前写入的事实和其他能力可能已经开始退化。
观点:很多研究都说明,Pretraining 出来的 model,如果在原有的基础之上直接训(不冻结),会很快的破坏其通用能力,这其实反映出来:当前的 LLM Model 并不适合直接用于做实时更新和持续学习,即使是 LoRA,由于和主干没有联合训练,在知识上也会有“断层”的问题。
直接给模型加 Memory Layer?
Continual Learning via Sparse Memory Finetuning
推理过程:模型结构里取 12nd layer 作为记忆层,把上一层的 output 作为 query,给到这一层的多个 slot,按 key 相似度求 top-k 个 slot,取出 slot 里的 value,投影后作为 output。每个 slot 有两个角色:
- key: 做 query 求相似度
- value:value 用于 output 投影
训练过程:每个 batch 里做 TF-IDF,取 top-t 个 slot 来做权重更新,只让新知识写入到指定的一小部分 slot。
Hybrid Memory
EvolveR / EMPO²,同时拓展记忆数据和训模型
- EvolveR,构建一个 loop:
- 从成功或失败轨迹中提炼自然语言原则,去重、合并并维护质量。
- 新任务中,Agent 自主检索原则或外部知识,产生新轨迹。
- 根据答案正确性与行为格式奖励,用 GRPO 更新策略参数。
- EMPO²,观察到记忆里的 reflection 能帮助解题,但是也让模型强依赖 reflection,所以构建三种数据组合:
- 不带记忆采样,按相同条件更新;
- 带记忆采样,保留提示更新;
- 带记忆采样,移除提示后进行 off-policy 更新;
GPT-4o 谄媚事故:用户喜欢,不一定意味着行为更好
OpenAI 2025 年 5 月 2 日的复盘 提供了一个非常具体的反馈优化案例(复盘了 2025 年 4 月 GPT‑4o 更新后的过度迎合问题:OpenAI 认为,用户反馈奖励与多项训练改动叠加,可能削弱了抑制迎合的机制,而评测和 A/B 测试未能及时发现问题,最终更新被回滚)。 OpenAI 后续关于敏感对话行为的说明也单独讨论情感依赖等问题。对一个长期记住用户的助手,这些行为需要纵向观察,单轮“用户更喜欢哪个回答”不一定能代表长期效果。
推荐系统和 Personal Agent
优化目标不一样
推荐系统优化的是类似 CTR 的互动行为,在做好内容管控后,应该是让用户“粘性”越大越好。而 Personal Agent 如果以人类偏好为准,则很容易出现类似 GPT 的 “谄媚事故”,所以 personal agent 会更加专注于用户给的 Task 是否能完成,这个角度去思考的话,他解决的还是一个 Agent 的能力是否满足需求的问题,而不是个性化的问题。
长回流的负反馈和 Agent 有些类似
推荐里有个很重要的问题是负反馈稀疏,如广告的 CVR 指标,转化数据远小于点击数据且转化周期很长,而解决方式则是通过 1) 正负样本配比 2) 建立负反馈回流机制。在 Agent 里同样,用户的负反馈通常是不完成任务,直接走开,那这种情况下也是一个低数量、不明确、反馈周期长的情况,或许可以在记忆构建或是样本采集的时候采用类似的方案。
特征工程或许能应用到记忆的权重里
上面提到,推荐里的 sparse 特征往往会分为短窗口/长窗口,其实人类的记忆也是类似的,对于近期记忆会更加清晰,且变化频率也是较快的。而 LLM 当前召回的方式如 RAG,并没有时间权重的概念,也是一个值得继续研究的思路。